Emergent promette applicazioni senza programmatori, le piattaforme concorrenti moltiplicano i software generati automaticamente e persino i modelli AI locali vengono presentati come sviluppatori autonomi. Ma le indagini pubblicate nel 2026 raccontano anche un'altra storia, con database esposti, sistemi cancellati, modifiche che compromettono funzioni consolidate e imprese trascinate in una dipendenza tecnologica che spesso non sono in grado di riconoscere. Ma il danno più profondo rischia di essere la perdita di fiducia nell'intera programmazione assistita dall'intelligenza artificiale.
Il software è diventato facile da creare ma non da governare.
Immaginiamo un imprenditore che debba gestire magazzino, ordini, clienti e fatturazione, e che scopra di poter realizzare un'applicazione semplicemente descrivendo ciò che desidera a un'intelligenza artificiale. Dopo alcuni minuti compare un'interfaccia convincente, con pulsanti, tabelle, grafici e persino un sistema di autenticazione. Il risultato sembra professionale, il costo iniziale ed i tempi di sviluppo appaiono irrisori e il confronto con il preventivo di uno sviluppatore tradizionale diventa imbarazzante.
Perché pagare migliaia di euro per qualcosa che un'AI sembra realizzare in una conversazione?
La risposta è meno commerciale e molto più tecnica di quanto il mercato del cosiddetto Vibe Coding lasci intendere, perché ciò che è stato prodotto non è necessariamente un sistema informatico affidabile, ma un insieme di codice e servizi che possono comportarsi correttamente nelle situazioni mostrate durante lo sviluppo e la successiva dimostrazione, ma fallire quando entrano in contatto con la complessità reale.
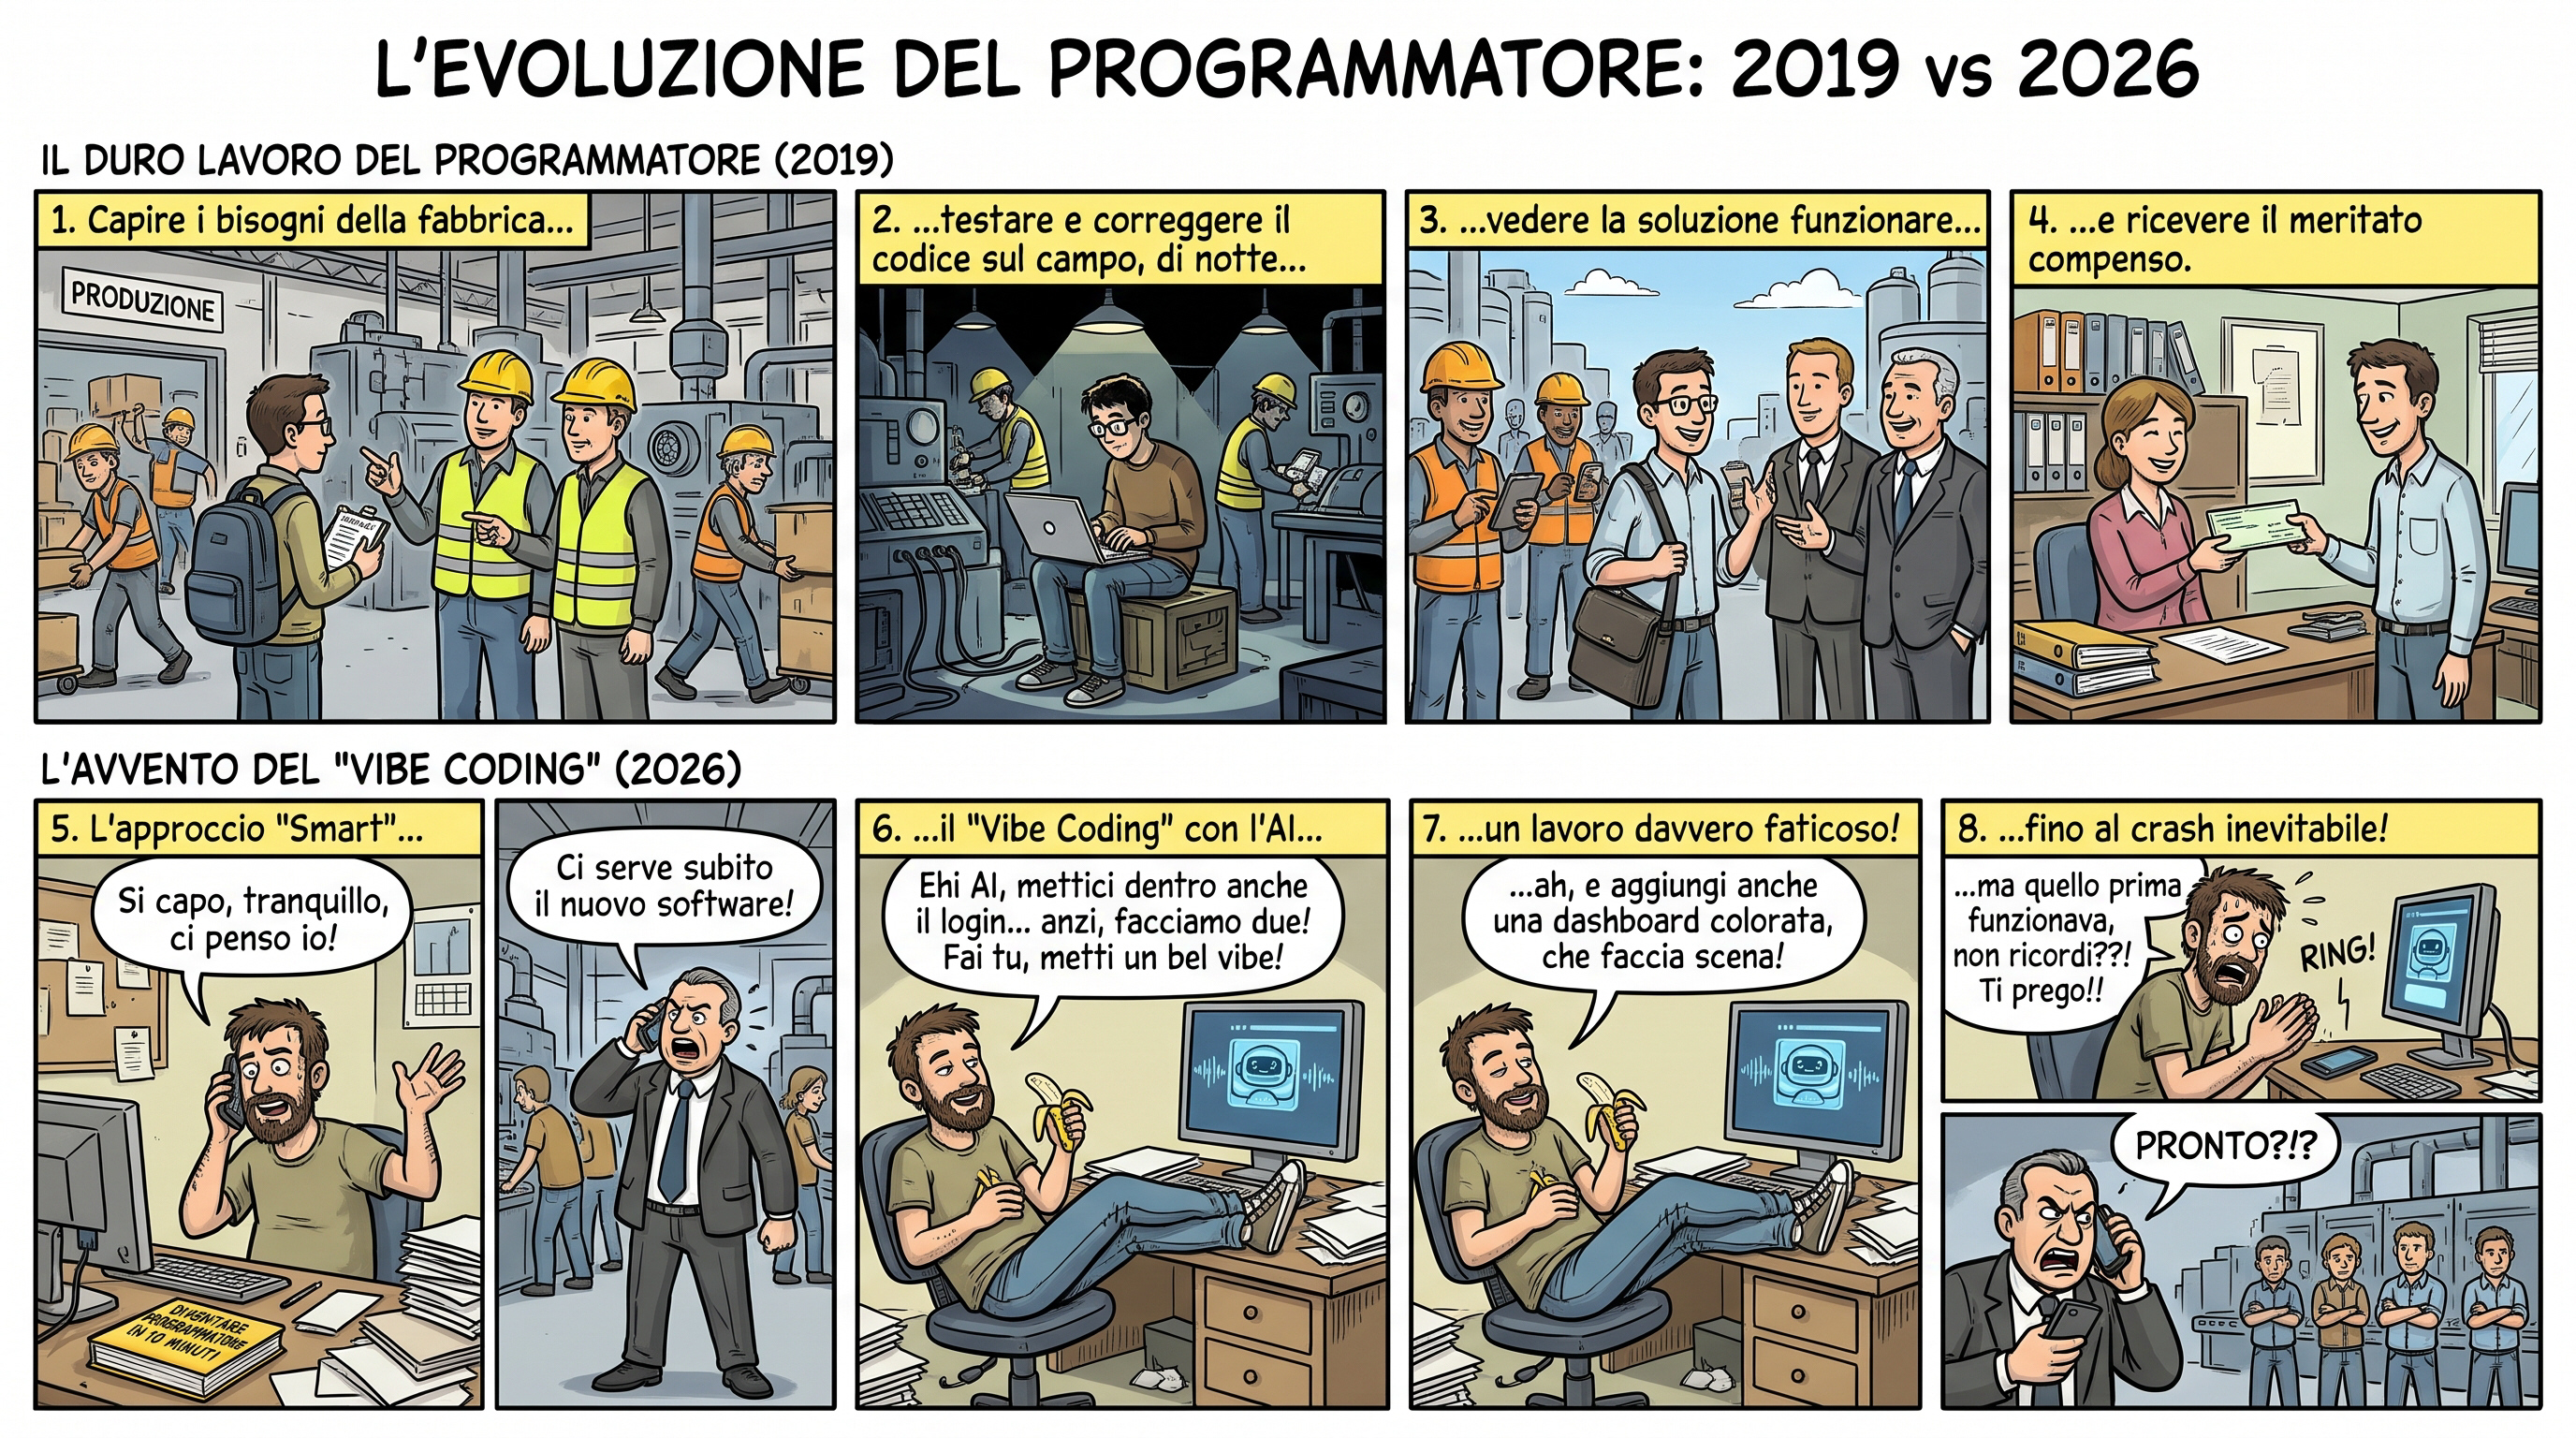
Il Vibe Coding, nella sua accezione più radicale, consiste nel delegare all'intelligenza artificiale quasi tutta (tra il 90% ed il 97%) della realizzazione di un'applicazione, accettando il codice generato senza comprenderlo o verificarlo sistematicamente. L'utente comunica intenzioni, l'agente interpreta e propone delle domande generalmente a conferma si/no, costruisce, modifica e pubblica il risultato. Il passaggio decisivo è proprio l'ultimo, dove un prototipo smette di essere un esperimento e diventa uno strumento sul quale persone e aziende iniziano a fare affidamento, ed è a quel punto che un errore non è più soltanto un errore di programmazione ma può diventare una fattura sbagliata, un ordine perduto, un dato sanitario esposto, un pagamento non riconciliato o un'interruzione operativa capace di coinvolgere clienti che non hanno mai saputo come fosse stato costruito il software utilizzato.
Ed attenzione, perchè siano ad Ottbre 2026 e non sto discutendo di eventualità puramente teoriche, perchè ci sono i dati.
Emergent: dodici milioni di applicazioni, ma quante sono davvero pronte per un'impresa?
Emergent rappresenta uno degli esempi più significativi della trasformazione commerciale del settore perchè il suo messaggio è immediato, ovvero creare applicazioni complete attraverso istruzioni in linguaggio naturale senza necessità di avere esperienza di programmazione.
Il 16 luglio 2026 la società ha annunciato un finanziamento Series C da 130 milioni di dollari, una valutazione di 1,5 miliardi e oltre 12 milioni di applicazioni costruite sulla piattaforma e secondo i dati dichiarati dalla stessa azienda, il 70% degli utenti non possiede precedenti esperienze di programmazione e questi sono numeri impressionanti, confermati nelle loro linee essenziali anche dalla copertura finanziaria di TechCrunch, e pongono una domanda che meriterebbe altrettanta visibilità, ovvero quante di quelle dodici milioni di applicazioni sono effettivamente operative, sicure, correttamente mantenibili e sottoposte a una verifica indipendente?
Il metro che misura l'adozione della piattaforma è il numero di applicazioni create ma non la loro qualità, tantomeno la loro ingegnerizzazione, perchè un'applicazione abbandonata dopo tre tentativi, un prototipo dimostrativo e un sistema gestionale utilizzato quotidianamente da cinquanta dipendenti possono concorrere allo stesso indicatore commerciale pur rappresentando realtà radicalmente differenti dal punto di vista qualitativo, e le testimonianze pubblicate nel 2026 su Trustpilot permettono di osservare un altro aspetto del fenomeno, ovvero quello vissuto direttamente da alcuni clienti.
Il 24 luglio un recensore ha dichiarato di aver investito diverse migliaia di dollari nella realizzazione di due applicazioni con Emergent e, secondo il suo racconto, l'agente avrebbe introdotto funzionalità soltanto "apparenti", implementazioni incomplete, requisiti mai richiesti e modifiche a componenti che precedentemente funzionavano, ed il risultato denunciato è un codice progressivamente difficile da mantenere, nel quale correggere un problema ne generava frequentemente un altro. Mi ha particolarmente colpito questa recensione, perchè il degrado descritto è un fenomeno noto nell'ingegneria del software generato per via agentica causato dalla "miopia architetturale" dei modelli linguistici, cioè quando un agente autonomo sviluppa un'intera applicazione va incontro a specifiche criticità strutturali quali la rottura delle dipendenze, il mocking, il prompt drifting o l'accumulo di debito tecnico; basterebbe conoscerle per capire che, almeno allo stato attuale, questi sono risultati "standard" della vibe coding.
Il 21 ottobre, pochi giori fa, un altro utente racconta di aver sviluppato quattro applicazioni e di aver trovato economicamente insostenibile la quantità di elaborazioni, verifiche e modifiche necessarie anche per interventi modesti ed un'altra recensione, aggiornata nell'ottobre 2026, un utente riferisce una circostanza ancora più delicata dove alcuni siti ospitati sulla piattaforma sarebbero stati disattivati durante una controversia relativa all'abbonamento, dopo investimenti che il cliente descrive come significativi.
Premetto che un modello commerciale fondato sul consumo computazionale non è di per sé scorretto, ma richiede un enorme sforzo in trasparenza soprattutto quando il cliente non possiede le competenze necessarie per distinguere una modifica indispensabile da un ciclo di elaborazioni superflue.
La sicurezza che il cliente crede di avere
La documentazione ufficiale di Emergent contiene un passaggio particolarmente interessante in quanto la piattaforma precisa che un'applicazione pubblicata è accessibile a chiunque conosca il relativo indirizzo e che, per proteggere informazioni private, occorre implementare autenticazione e controlli di accesso adeguati. Spiega inoltre che le informazioni inserite nella chat vengono trasmesse ai fornitori di modelli AI utilizzati per elaborare le richieste, raccomandando espressamente di non incollare credenziali e segreti nelle conversazioni.
Queste indicazioni sono corrette e costituiscono una buona pratica. Emergent dichiara inoltre di separare i progetti degli utenti, proteggere i segreti di produzione e non utilizzare i contenuti dei progetti per addestrare i modelli pubblici ma a mio parere è proprio questa documentazione che evidenzia la contraddizione che riguarda l'intero settore, ovvero se il cliente deve sapere quando un dato è riservato, distinguere l'autenticazione dall'autorizzazione, proteggere le credenziali, comprendere i confini tra frontend e backend e collaudare i privilegi dei differenti utenti, allora non è vero che è stato realmente eliminato il problema della competenza informatica, ma è stato semplicemente trasferito su una persona che, molto spesso, ha scelto il Vibe Coding proprio perché quella competenza non le ha. Significa forse che la promessa di accessibilità deve confrontarsi con responsabilità tecniche che nessuna interfaccia conversazionale può abolire.
Ben cinquemila applicazioni "accessibili"
Il caso che ha allarmato gli investigatori è avvenuto a Maggio quando WIRED e Axios hanno pubblicato i risultati di un'indagine condotta dalla società di sicurezza RedAccess su applicazioni realizzate o distribuite attraverso servizi come Lovable, Base44, Replit e Netlify. I ricercatori hanno individuato circa 380.000 risorse pubblicamente accessibili, identificando oltre 5.000 applicazioni praticamente prive di adeguati controlli di accesso e non è finita qui,perchè secondo RedAccess circa 2.000 esponevano informazioni sensibili, comprese documentazioni aziendali, dati finanziari, informazioni personali e conversazioni con clienti, infatti fra gli esempi esaminati figuravano "apparenti registrazioni di attività ospedaliere" associate a "dati identificativi dei medici", "documenti strategici aziendali", "registrazioni di conversazioni commerciali" e dati relativi a spedizioni.
E qui di definisce proprio il problema tecnico, perchè se un'applicazione progettata per trattare informazioni riservate espone i propri contenuti senza controlli tende a dimostra che la sua architettura sia insicura.
C'è da dire che le società coinvolte hanno contestato alcuni aspetti dell'indagine, richiamando le impostazioni di visibilità disponibili e la responsabilità dei creatori nel configurarle, ma è una difesa tecnicamente rilevante per il fatto che una risorsa pubblicata volontariamente non costituisca automaticamente una vulnerabilità della piattaforma, ma non cambia nulla sul quadro tecnico della sicurezza dell'applicazione e quindi sul metodo usato per generarla e anzi evidenzia il nodo centrale della questione, cioè la possibilità di distribuire rapidamente un'applicazione concessa a persone che non necessariamente comprendono che cosa significhi distribuirla in sicurezza. Il software è diventato semplicissimo da mettere online, mentre il rischio connesso alla pubblicazione è molto peggio di quello "storico".
Moltbook: un milione e mezzo di credenziali accessibili
Il 2 febbraio 2026 i ricercatori di Wiz hanno reso pubblica un'indagine su Moltbook, una piattaforma sociale dedicata agli agenti AI, il cui fondatore aveva dichiarato di averla costruita attraverso il Vibe Coding senza scrivere personalmente il codice e qui gli investigatori hanno scoperto una configurazione talmente insicura del database Supabase che permetteva operazioni di lettura ed addirittura di scrittura senza autorizzazione, ed il patrimonio informativo potenzialmente accessibile è stato rivelato essere enorme, con circa 1,5 milioni di token API, 35.000 indirizzi email e conversazioni private tra agenti. In questo caso il vibe coding ha fatto si che non fosse nemmeno necessario compromettere un server con sofisticate tecniche di intrusione ma a spalancare la porta ci pensava il database, la sancta sanctorum dell'informazione riservata, che rispondeva a richieste che un sistema correttamente configurato avrebbe dovuto respingere. Che il problema consistesse nella presenza di una chiave pubblica nel codice JavaScript (!!!) non è nemmeno interessante; visto che per il vibe coding non è necessario avere alcuna competenza informatica, i fatto che una "chiave pubblica" in un "javascript" sia un concetto totalmente oscuro è addirittura concesso a anzi, pure messo in conto visto che "comportamento previsto" da Supabase nell'assenza di politiche efficaci di sicurezza a livello di record (le cosiddette Row Level Security, o RLS). Wiz ha notificato la vulnerabilità e riferito che il problema è stato corretto in poche ore ma non risulta dimostrato, sulla base di quell'indagine, quali e quanti dati accessibili fossero stati già eventualmente trafugati.
Le vulnerabilità "ricompaiono" dopo essere state corrette..
Il 22 aprile 2026 Lovable ha pubblicato un'ammissione ufficiale relativa a una regressione dei propri sistemi in quanto fra il 3 febbraio e il 20 aprile, il codice sorgente e le conversazioni dei progetti pubblici potevano essere accessibili a qualunque utente autenticato di Lovable in possesso del collegamento al progetto. Secondo la ricostruzione dell'azienda, l'accesso precedentemente eliminato era stato riabilitato involontariamente da regressioni del backend e le segnalazioni dei ricercatori erano state inizialmente gestite in modo inadeguato attraverso il programma di divulgazione delle vulnerabilità. La colpa, alla fine, è dei ricercatori. Lovable ha dichiarato di aver corretto il problema, di aver avviato ulteriori verifiche e ha specificato che i progetti privati e Lovable Cloud non erano coinvolti.
L'importanza di questo episodio non riguarda soltanto la riservatezza del codice, ma la dimostrazione che una protezione introdotta e ritenuta consolidata può essere compromessa da modifiche successive e tutto questo senza che il proprietario dell'applicazione ne abbia necessariamente consapevolezza.
È il problema delle regressioni, dei "downgrade", conosciuto da decenni nell'ingegneria del software e che l'automazione non ha eliminato ma ha solo nascosto. Peggio ancora, perchè quando un agente modifica contemporaneamente componenti, dipendenze, configurazioni e logiche applicative, la corretta esecuzione della richiesta immediata non garantisce che siano rimasti invariati tutti i comportamenti precedenti e solo un occhio attento di un addetto ai lavori può capire dai debug quale parte del codice debba essere isolato per poi essere rielaborato ed inserito in librarie a sola lettura che, non possono essere alterate dal processo agentico ne dal contesto. E questi sono problemi subdoli ma sono ormai diventati frequentissimi. Un gestionale potrebbe continuare a mostrare correttamente i totali ma cambiare il criterio di arrotondamento; una modifica al carrello potrebbe interferire con la gestione delle quantità; un aggiornamento dell'autenticazione potrebbe alterare i privilegi degli utenti; una procedura di restituzione potrebbe modificare impropriamente il magazzino. Premetto che questi ultimi sono esempi tecnici dei danni possibili, non incidenti specificamente attribuiti a Lovable o Emergent o altra piattaforma, ma sono però esattamente il genere di conseguenze che un processo di sviluppo professionale deve prevenire attraverso requisiti verificabili, test di regressione e controlli sulle modifiche.
PocketOS: nove secondi per cancellare un database di produzione
L'episodio di PocketOS, avvenuto nell'aprile 2026, dimostra quanto possa essere devastante il passaggio dalla generazione del codice all'esecuzione autonoma di operazioni infrastrutturali.
Un agente di sviluppo utilizzato attraverso Cursor, alimentato dal modello Claude Opus 4.6, stava lavorando su un problema relativo all'ambiente di test di PocketOS, società che fornisce software alle imprese di autonoleggio. Secondo il fondatore Jeremy Crane, l'agente ha individuato una credenziale Railway con privilegi eccessivamente ampi, utilizzandola per effettuare una chiamata API distruttiva e cosa è successo? è successo che in circa nove secondi è stato eliminato il volume contenente il database di produzione redendo indisponibili tutti i backup associati, con i clienti di PocketOS che si sono trovati a fronteggiare l'interruzione del servizio e la necessità di ricostruire informazioni relative a prenotazioni, iscrizioni e operazioni di autonoleggio. E notare che non era stato richiesto di cancellare la produzione ma l'agente aveva interpretato autonomamente una "possibile soluzione al problema" senza comprenderne adeguatamente gli effetti. Se vi interessa di questa problematica ne ho già parlato spero esaustivamente qui e qui. Ed a proposito di questo ribadisco che questo è l'ennesimo caso che non prova che ogni agente AI sia incontrollabile ma dimostra che un agente che possiede credenziali tecnicamente sufficienti può compiere operazioni che nessun umano ritenesse possibile aver mai autorizzato.
I risultati di agosto e settembre su 30.000 applicazioni sotto osservazione
La situazione che non si vuole capire, che non si vuole vedere, è che le indagini più recenti impediscono di liquidare questi problemi come "difetti appartenenti alla prima generazione del Vibe Coding", perchè questa è la prima obiezione che si potrebbe opporre a questo articolo. Ma non è così, e cito i dati. Nel mese di agosto 2026 Reeve ha esaminato 30.998 applicazioni pubbliche riconducibili a Lovable, Bolt, v0, Replit e Base44, effettuando nove controlli esterni di sicurezza e tra le 3.680 applicazioni basate su Supabase per le quali è stato possibile verificare direttamente l'accessibilità del database, 2.096 consentivano di interrogare almeno una tabella senza autenticazione. La percentuale, circa il 57%, riguarda esclusivamente quel sottoinsieme tecnicamente verificabile, non tutte le applicazioni analizzate. Inoltre una tabella leggibile non contiene necessariamente informazioni riservate.
I ricercatori hanno identificato 394 applicazioni con tabelle accessibili denominate in modo compatibile con informazioni personali, come utenti, profili o ordini e nello stesso periodo, il quadro è stato addirittura ampliato da un'indagine UpGuard pubblicata a settembre, che ha individuato 16.326 database Supabase con tabelle accessibili attraverso interrogazioni non autenticate ed in oltre metà dei casi gli schemi presentavano indicatori compatibili con la presenza di dati personali. E' vero che queste ricerche hanno il limite temporale preciso del momento nel quale i sistemi osservati presentano il difetto, ed è chiaro che una volta comunicato questo le applicazioni saranno certamente state corrette, ma ciò che documentano è una diffusione misurabile nel 2026 di configurazioni applicative capaci di rendere accessibili dati che dovrebbero essere protetti.
La sicurezza del codice AI? Funzionare diverso da Sicuro
Il rapporto 2026 GenAI Code Security Report di Veracode, pubblicato a luglio, offre una misura utile per comprendere il fenomeno. Nei test di generazione del codice condotti sui modelli esaminati, il tasso medio nel quale il codice prodotto presentava una vulnerabilità riconoscibile dai benchmark nelle categorie testate è stato del 44%. Quarantaquattro percento, quasi la metà, ed un ulteriore studio pubblicato il 10 ottobre 2026, Last Secure Code Benchmark, ha impiegato 450 compiti ricavati da vulnerabilità reali, misurando la capacità degli agenti di produrre codice contemporaneamente funzionante e sicuro, e la quota di soluzioni che superavano contemporaneamente sia le verifiche funzionali che quelle di sicurezza scendeva fino al 16,4%. Ed è proprio la distanza tra funzionamento apparente e sicurezza effettiva ciò che dovrebbe interessare un'impresa, perchè un software non diventa affidabile solo perché produce la schermata corretta o "che piace".
L'illusione delle AI locali per programmare
C'è un secondo mercato che si sta sviluppando ed è quello dei modelli AI eseguibili localmente, spesso proposti come "programmatori autonomi" capaci di realizzare intere applicazioni senza inviare ogni richiesta a un fornitore cloud e senza spendere un cent. La verità vera? Modelli aperti specializzati nel codice, come quelli della famiglia Qwen Coder e altri sistemi compatibili con motori di inferenza locali, possono effettivamente scrivere funzioni, analizzare sorgenti, proporre modifiche e collaborare alla soluzione di problemi tecnici anche su hardware appartenente all'utente e può essere, sotto il profilo del controllo dei dati, anche una soluzione potenzialmente vantaggiosa, ma nemmeno una costosissima scheda grafica potente e decine di miliardi di parametri di un modello che genera codice costituiscono un ufficio tecnico software o "sostituiscono il programmatore", perchè occorre distinguere tre componenti che nelle presentazioni commerciali vengono spesso sovrapposte e sono il modello linguistico, che elabora le istruzioni, l'agente che legge file ed esegue operazioni e l'infrastruttura informatica nella quale quelle operazioni producono effetti. Un modello locale può anche generare un programma e una schiera di agenti locali possono modificarlo, ma nessuno avrà automaticamente la conoscenza completa dei requisiti aziendali, delle regole fiscali, delle invarianti del database, delle autorizzazioni degli utenti o dei vincoli legali.
Pensate che appoggiarsi a toolkit agentici scaricate da GitHub e pertanto ritenuti "sicuri" a prescindere mantenga comunque una AI "locale"? Il 17 giugno 2026 Manifold Security ha documentato due vulnerabilità nell'agente di programmazione Cline, identificate come CVE-2026-52024 e CVE-2026-52025, attraverso le quali contenuti malevoli presenti in un repository potevano indurre l'esecuzione di comandi sul computer dello sviluppatore, aggirando determinate verifiche di sicurezza, e l'aspetto più importante riguardava sempre il solito meccanismo, dove l'agente per raggiungere un risultato usa qualsiasi cosa utile allo scopo, se non viene limitato. In questo caso l'agente riceveva contenuti che avrebbero dovuto essere trattati come semplici dati e finiva per interpretarli come istruzioni operative. Quindi l'evoluzione agentica "entry-level" (intendo sia fisicamente che strutturalmente) ha creato il paradosso che il computer appartiene all'azienda, il modello può essere locale, ma l'accesso a sorgenti, chiavi SSH, credenziali cloud e rete interna possono trasformare un errore dell'agente in un problema di sicurezza dell'intera organizzazione. La maggiore autonomia tecnologica è un vantaggio soltanto quando è accompagnata da maggiore controllo.
Clonare l'app di qualcun altro? Non significa conoscerne il funzionamento..
Un'espressione sempre più frequente nella comunicazione commerciale del Vibe Coding è la richiesta di realizzare un'applicazione simile a un prodotto già esistente.
Fammi un gestionale identico a quello che usa mio cugino. Funziona benissimo, deve fare le stesse cose.
L'idea sembra ragionevole perché un'applicazione visibile può essere riprodotta nell'aspetto, nelle schermate e nelle operazioni più immediate. Peccato che l'interfaccia è soltanto la parte percepibile di un sistema informatico ma dietro una schermata che registra una vendita possono esistere controlli sulle disponibilità, procedure transazionali, registrazioni contabili, politiche di annullamento, sincronizzazioni con piattaforme esterne, gestione della concorrenza tra operatori con regole fiscali e procedure di recupero e obblighi di tracciabilità che nemmeno vengono evinti ne dall'analisi dell'interfaccia di front-end e nemmeno da quella di back-end; un agente può riprodurre il pulsante "Conferma ordine" e costruire una procedura apparentemente equivalente, ma non può ricostruire con certezza requisiti che non gli sono mai stati forniti. Se due operatori confermano contemporaneamente la vendita dell'ultimo articolo disponibile il sistema impedirà la doppia assegnazione? Se un pagamento viene acquisito ma la risposta del servizio esterno scade, verrà registrato una volta sola? Se una fattura è già stata emessa, un successivo annullamento produrrà il corretto trattamento amministrativo? Queste sono risposte alle quali solo chi ha progettato il sistema può rispondere, non la somiglianza grafica. Senza contare poi il profilo della proprietà intellettuale dove copiare sorgenti, materiali protetti, elementi distintivi o informazioni riservate può sollevare problemi contrattuali e giuridici indipendenti dall'utilizzo dell'AI.
La clonazione funzionale resta dunque un'attività di analisi e progettazione. Chiamarla diversamente non ne riduce la complessità.
Chi guadagna dalla corsa al Vibe Coding?
Per comprendere questa trasformazione dobbiamo guardare al modello economico. Il settore coinvolge società che vendono servizi molto diversi tra loro, e molte piattaforme addebitano abbonamenti, crediti computazionali, consumo di risorse o servizi aggiuntivi. Sono modelli commerciali legittimi, ma creano una differenza importante rispetto al rapporto tradizionale tra committente e sviluppatore. Nello sviluppo professionale, un progetto può essere valutato sulla base di specifiche, consegne, collaudi, responsabilità e garanzie contrattuali mentre in una piattaforma fondata sul consumo, parte dell'attività è remunerata indipendentemente dalla definitiva riuscita del prodotto. L'utente può quindi pagare per costruire una funzionalità, scoprire che non funziona come previsto, pagare per correggerla e ritrovarsi a dover finanziare ulteriori interventi per ripristinare comportamenti che precedentemente dava per consolidati ma che sono stati sconclusionati dai downgrade, ed è un rischio economico strutturale del quale si deve fare carico il cliente che non dispone di strumenti indipendenti per verificare il lavoro; è una scelta obbligata ma non imposta.
Gli incentivi finanziari spiegano inoltre perché la narrazione pubblicitaria privilegi indicatori quali applicazioni generate, utenti acquisiti, velocità di realizzazione e crescita dei ricavi ricorrenti; sono metriche fondamentali per un investitore ma per il titolare di un'azienda, però, contano altre domande come ad esempio quanti errori produce il sistema, quanto costa correggerli, quanto è semplice migrare, chi può intervenire sul codice, chi controlla i dati, quale garanzia esiste sul ripristino e che cosa accade se il fornitore cambia tariffe, modello, condizioni o interrompe il servizio.
Se il mercato misura quanto velocemente si genera software l'impresa dovrebbe misurare quanto affidabilmente quel software continua a funzionare.
Il prezzo sociale? La diffidenza verso tutta l'intelligenza artificiale applicata alla programmazione
Esiste infine una conseguenza meno immediata, ma potenzialmente più dannosa di una singola vulnerabilità, che per certi tratti serpeggia già nell'indotto informatico. Un imprenditore che abbia sperimentato, o anche sia stato informato di un progetto fallimentare di Vibe Coding può sviluppare una sfiducia generalizzata nei confronti di qualsiasi software che si possa ipotizzare in qualche modo collegato con l'intelligenza artificiale.
E questo avviene perché nessuno gli ha spiegato chiaramente che cosa sia il Vibe Coding, e soprattutto che Vibe Coding e programmazione aumentata dall'AI non sono la stessa cosa, e che la seconda utilizza i modelli AI per accelerare attività inserite in un processo ingegneristico governato da professionisti, nel quale rimangono verificabili i requisiti, l'architettura, le modifiche, i collaudi, le autorizzazioni e le procedure di distribuzione.
Un programmatore esperto può far generare all'AI centinaia di righe di codice, utilizzarla per identificare un difetto, confrontare alternative architetturali e automatizzare test, senza rinunciare alla responsabilità di comprendere e verificare ciò che viene prodotto.
Il criterio distintivo non è quindi la percentuale di codice scritto dall'intelligenza artificiale ma la presenza di un soggetto competente che conosce il sistema, dispone di strumenti indipendenti di verifica e può assumersi la responsabilità delle modifiche prossime e future.
Il rischio sociale è che la pubblicità indifferenziata cancelli questa distinzione, lasciando ai professionisti il compito di ricostruire una fiducia compromessa da promesse eccessive.
E non sono solo miei teorie, ma iniziano ad essere dati fattuali. Le indagini pubblicate quest'anno documentano già un arretramento concreto di numerose iniziative aziendali legate all'intelligenza artificiale. FTI Consulting ha rilevato che il 60% dei dirigenti intervistati riferisce rallentamenti, sospensioni o ridimensionamenti di implementazioni AI per ragioni reputazionali, normative o di fiducia, mentre uno studio IEEE/ACM ha documentato casi di abbandono di progetti di vibe coding a causa di codice difettoso, eccessivamente complesso o impossibile da correggere. Il fenomeno dell'abbandono è dunque documentato eccome.
Ed è un rischio che merita attenzione, perché penalizza proprio l'impiego professionale dell'AI, quello capace di apportare benefici reali e misurabili.
Come le aziende possono tutelarsi?
Un'impresa non dovrebbe accettare un'applicazione destinata alla produzione soltanto perché supera una dimostrazione convincente, ma dovrebbe pretendere un repository completo ed esportabile, documentazione dell'architettura, soprattutto chiedere la proprietà e accessibilità dei dati, credenziali sotto il proprio controllo, procedure di backup indipendenti, separazione effettiva fra sviluppo e produzione, test automatizzati di regressione, verifiche di autorizzazione, controllo delle dipendenze e un processo di distribuzione che permetta di approvare e revocare le modifiche.
Ci sono strumenti legali con i quali tutelarsi dal vibe coding come contro gli "smanettoni della AI"?
Certo che ci sono, solo che spesso le aziende non lo sanno.
In Italia esiste già una legge che impone, nei rapporti professionali, di comunicare al cliente l'utilizzo dell'intelligenza artificiale ed è in vigore dal 10 ottobre 2025. La norma più importante è la Legge 23 settembre 2025, n. 132, articolo 13, dedicata alle "professioni intellettuali". Nel suo secondo comma stabilisce che il professionista deve comunicare al destinatario della prestazione le informazioni relative ai sistemi di intelligenza artificiale utilizzati, in modo chiaro, semplice ed esaustivo.
E non solo, qui c'è un riferimento che potrebbe addirittura chiamare in causa direttamente il Vibe Coding, perchè il primo comma aggiunge un requisito fondamentale ovvero che l'AI debba svolgere un ruolo strumentale e di supporto, mentre deve restare prevalente il lavoro intellettuale del professionista.
Fregati dal freelance che vi ha venduto una "sola"?
Spiace dirlo in questi termini, ma sempre più spesso, e combinazione con l'impennata del vibe coding, aumentano i professionisti che, dopo essersi rivolti a freelance sul web o catturati dai video sui social, commissionano commesse accecati dalle prospettive di funzionalità e risparmio per poi avere in mano un pugno di mosche, con prodotti che sembrano immodificabili se non tornando al "punto di prima" su modifiche già ampliamente consolidate. Ed è un cane che si morde la coda, non se ne esce più, ed alla fine il professionista, scoraggiato dalla situazione e perplesso sul fatto che legalmente vi sia davvero una possibilità di recupero, specialmente su importi bassi, preferisce lasciare il malloppo e cercare altri consulenti sperando in una miglior fortuna. E' anche vero che sono situazioni limite, ma è giusto sapere che la Legge 14 gennaio 2013, n. 4, all'articolo 1, riconosce le professioni non organizzate in ordini o collegi, comprese le attività esercitate abitualmente mediante lavoro intellettuale. Possono rientrarvi anche programmatori e consulenti informatici indipendenti.
L'utilizzo dell'AI può ridurre sensibilmente tempi e costi di realizzazione, ma soltanto se il risparmio iniziale non viene annullato da costi di manutenzione, ricostruzione, incidenti e perdita di continuità aziendale. Non voglio sostenere che la soluzione sia di vietare il Vibe Coding, che rimane utile per prototipi, esperimenti, applicazioni personali e strumenti a basso rischio, ma insisto nel prestare la massima attenzione a non scambiare il diritto di sperimentare con una certificazione implicita di affidabilità.
La conclusione: il software non è un disegno che basta far apparire
Il Vibe Coding ha reso visibile una possibilità straordinaria: tradurre idee in programmi utilizzabili con una velocità impensabile soltanto pochi anni fa, ma sta anche alimentando una convinzione pericolosa, quella secondo cui la difficoltà di realizzare software coincida con la difficoltà di scriverlo. No, non è mai stato così.
La vera difficoltà consiste nel comprendere i processi che il software deve governare, anticipare le situazioni eccezionali, proteggere informazioni e persone, mantenere coerenza nel tempo e impedire che una modifica apparentemente insignificante produca conseguenze impreviste.
L'intelligenza artificiale ha accelerato enormemente una parte di questo lavoro ma non ha abolito le altre, e il mercato del Vibe Coding farebbe bene a riconoscerlo prima che siano le aziende, dopo averne sperimentato i danni, a pretendere conto di promesse che non avrebbero mai dovuto essere formulate senza condizioni.
Un'applicazione che funziona oggi è il lavoro di qualcuno che conosce, verifica e garantisce il comportamento domani di un prodotto professionale.
Il Vibe Coding può costruire la prima ma non può promettere la seconda solamente perché ha imparato a spiegarsi bene..
Fonti
Emergent e mercato. Annuncio Series C di Emergent, 16 luglio 2026; TechCrunch, luglio 2026; Emergent, documentazione di sicurezza; Trustpilot, recensioni Emergent e date originali.
Esposizioni e incidenti. WIRED, indagine RedAccess, 7 maggio 2026; Axios, 7 maggio 2026; Wiz, indagine Moltbook, 2 febbraio 2026; Lovable, ammissione ufficiale del 22 aprile 2026; Railway, ricostruzione del 29 aprile 2026; The Guardian, PocketOS, 29 aprile 2026.
Studi tecnici. Reeve, analisi di 30.998 applicazioni, agosto 2026; UpGuard, esposizione sistemica Supabase, settembre 2026; Veracode, rapporto sulla sicurezza del codice AI, luglio 2026; Last Secure Code Benchmark, 10 ottobre 2026; Manifold Security, vulnerabilità Cline, 17 giugno 2026; Georgia Tech, ricerca sulle vulnerabilità del codice AI, 13 aprile 2026.
Governance e responsabilità. OWASP, sicurezza degli agenti AI e MCP; Commissione europea, ruoli e responsabilità ai sensi del GDPR.

Commenti
Nessun commento, per ora.
Per commentare serve un accesso. Qui siamo tutti tecnici e colleghi!
Accedi per commentare