Le Self-Healing Codebases rappresentano il passaggio dall'AI che suggerisce codice all'AI che mantiene autonomamente un progetto nel tempo, perché agenti collegati a repository, test e pipeline CI/CD possono intercettare un errore, ricostruirne il contesto, modificare i file, compilare, rieseguire i test e preparare una patch verificata. Nel 2026 questa non è più soltanto un'idea sperimentale, anche se l'ultima decisione su cosa portare in produzione deve rimanere governata.
Il salto vero non è scrivere codice, ma scriverlo vivo
Usando qualsiasi assistente alla programmazione ci si accorge di quanto rapidamente siamo passati dal completamento automatico di una riga alla generazione di funzioni intere, poi alla modifica coordinata di più file ed infine agli agenti capaci di aprire un repository, leggere il progetto, eseguire comandi e lavorare per parecchi minuti senza aspettare una nostra istruzione ad ogni passaggio. Ma il cambiamento che considero più importante arriva adesso, perché l'AI sta smettendo di essere soltanto qualcosa che ci aiuta mentre SCRIVIAMO il software ed incomincia ad occuparsi anche di ciò che succede DOPO, quando quel software deve continuare a funzionare per mesi oppure anni mentre cambiano dipendenze, API esterne, versioni del compilatore, configurazioni, database, librerie, requisiti di sicurezza ed inevitabilmente anche il codice scritto dagli esseri umani.
È qui che entra il concetto di Self-Healing Codebase, cioè una base di codice che possiede attorno a sé un sistema capace di osservare i propri segnali di malfunzionamento e tentare una riparazione. Non parlo di un programma che misteriosamente comprende di avere un bug e riscrive se stesso dentro la produzione senza controllo, perché questa sarebbe una descrizione spettacolare ma tecnicamente sbagliata, parlo piuttosto di un'architettura nella quale test automatici, log, stack trace, risultati della compilazione, scanner di sicurezza, metriche, issue ed eventi della pipeline diventano sensori, mentre uno o più agenti AI ricevono questi segnali, ricostruiscono il problema, lavorano in un ambiente isolato, modificano il repository e verificano se la modifica ha realmente riportato il sistema nello stato atteso. La parte nuova non è quindi la singola patch generata dall'AI, che ormai abbiamo visto migliaia di volte, ma IL CICLO CHIUSO fra errore, diagnosi, modifica e verifica.
Un software che possiede finalmente un riflesso automatico
Il modello mentale che uso è abbastanza semplice, perché una pipeline tradizionale sa già accorgersi che qualcosa è andato storto ma normalmente si ferma proprio lì. Un commit entra nel repository, parte la CI, il progetto viene compilato, girano unit test, integration test, lint, controlli di sicurezza ed eventualmente test end-to-end, poi uno di questi fallisce e la macchina produce un risultato rosso, con un log che qualcuno dovrà leggere il mattino seguente. La Self-Healing Codebase aggiunge un anello successivo, nel quale quel risultato non è soltanto una notifica ma diventa l'INPUT di un agente, che può leggere il log, individuare il test fallito, aprire i file coinvolti, usare Git per risalire alle modifiche recenti, riprodurre localmente l'errore, formulare un'ipotesi, cambiare il codice e rieseguire esattamente la stessa verifica che aveva rilevato il problema.
In forma molto schematica potremmo descrivere il ciclo come osservazione, diagnosi, patch, validazione e proposta, ma nella pratica queste fasi non rimangono così pulite perché un agente serio procede per tentativi, torna sui propri passi e raccoglie nuovo contesto. Se il compilatore segnala che una funzione non esiste più dopo l'aggiornamento di una libreria, l'agente può cercarne gli utilizzi, leggere la versione installata, individuare l'API sostitutiva, modificare il codice e compilare di nuovo; se un test continua a fallire, può confrontare l'output atteso con quello reale e capire se ha corretto il punto sbagliato; se invece la correzione fa passare quel test ma ne rompe altri trenta, la pipeline gli sta dicendo una cosa molto importante, ovvero che la patch locale non conserva le invarianti dell'intero sistema. In questo senso i test smettono di essere soltanto una barriera che blocca il codice difettoso e diventano la FUNZIONE DI VERIFICA attraverso la quale l'agente capisce se ciò che ha fatto è accettabile.
Nel 2026 non è più solo una teoria
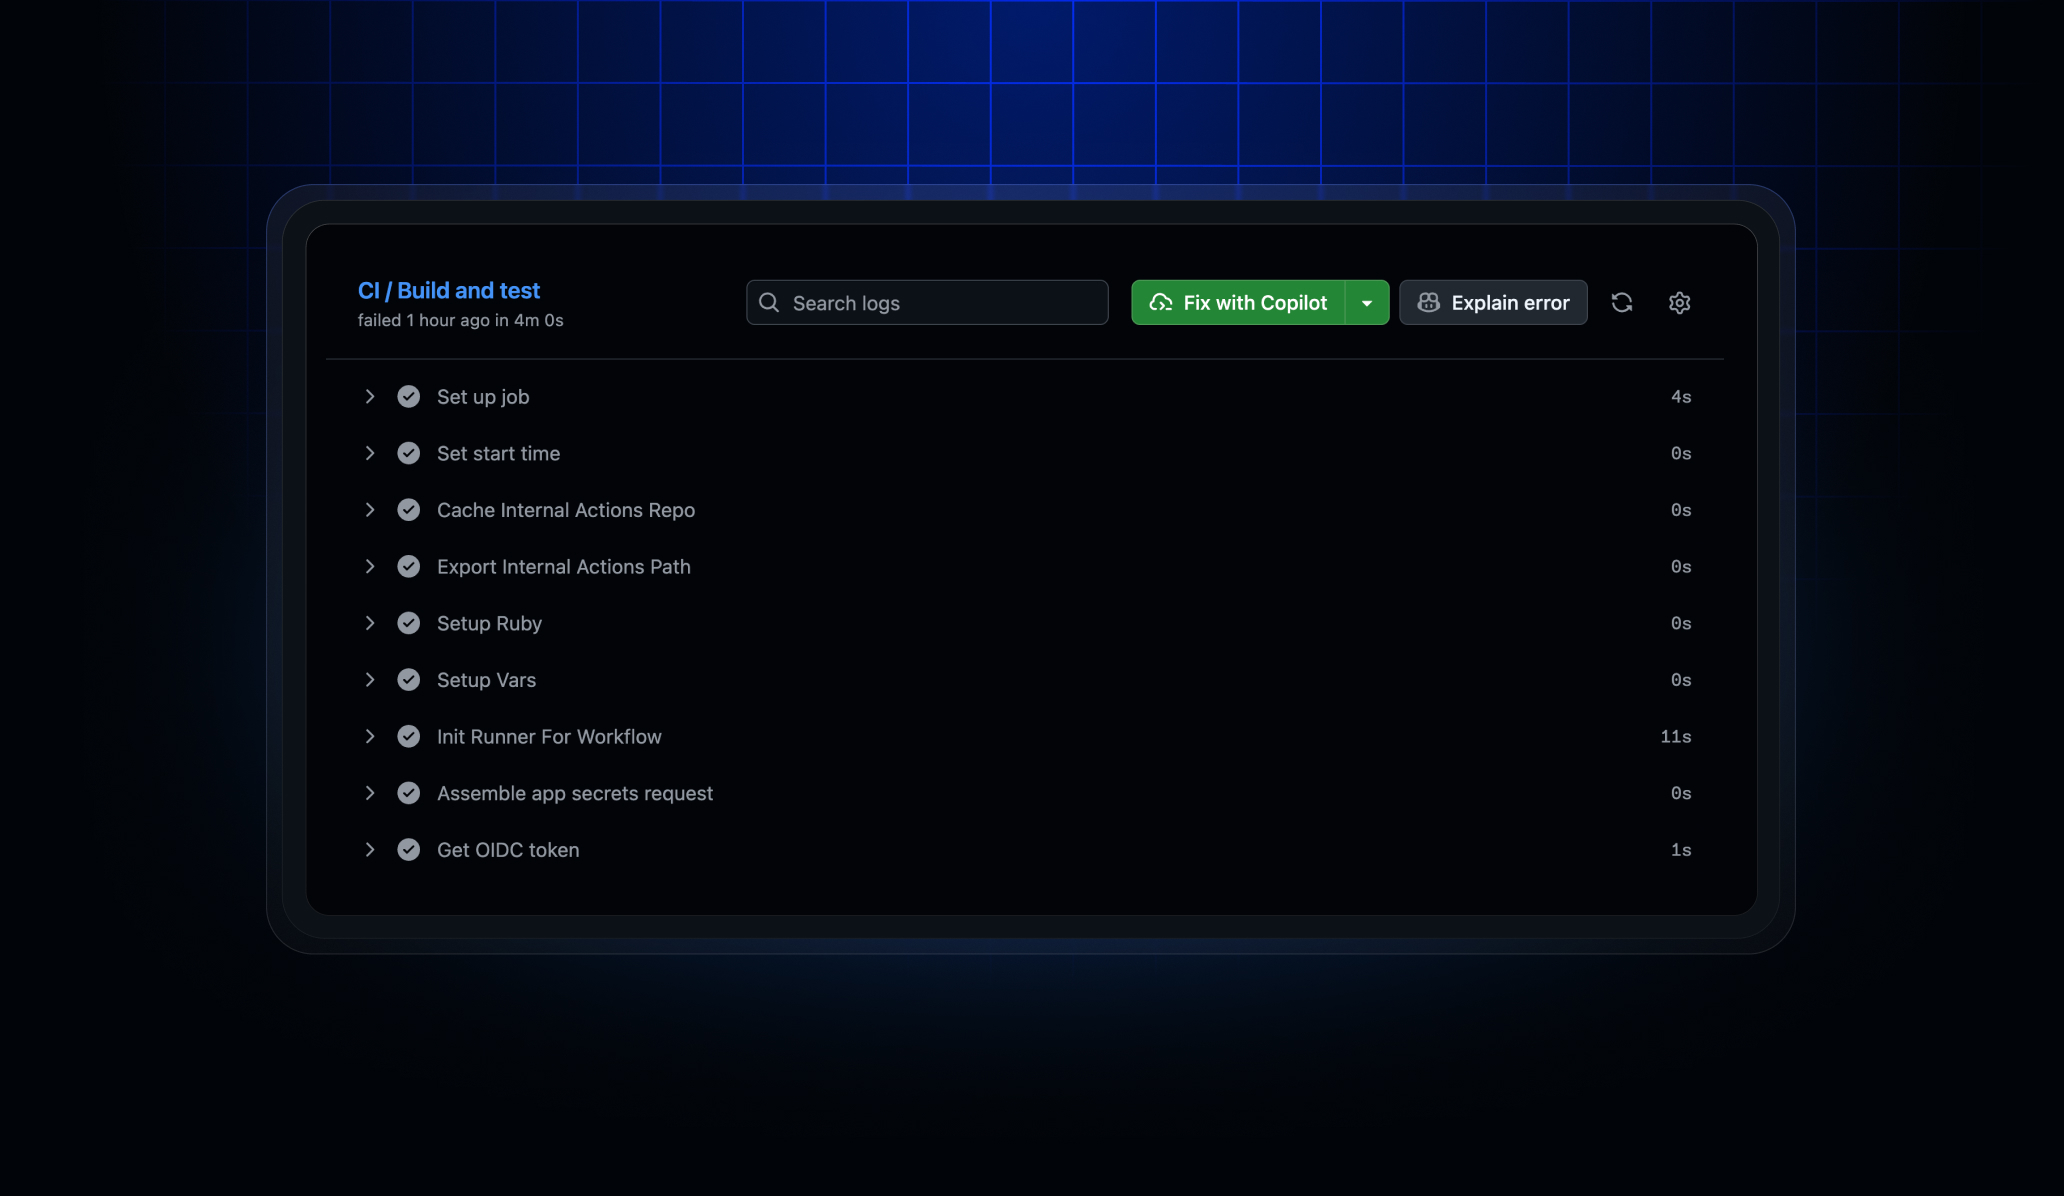
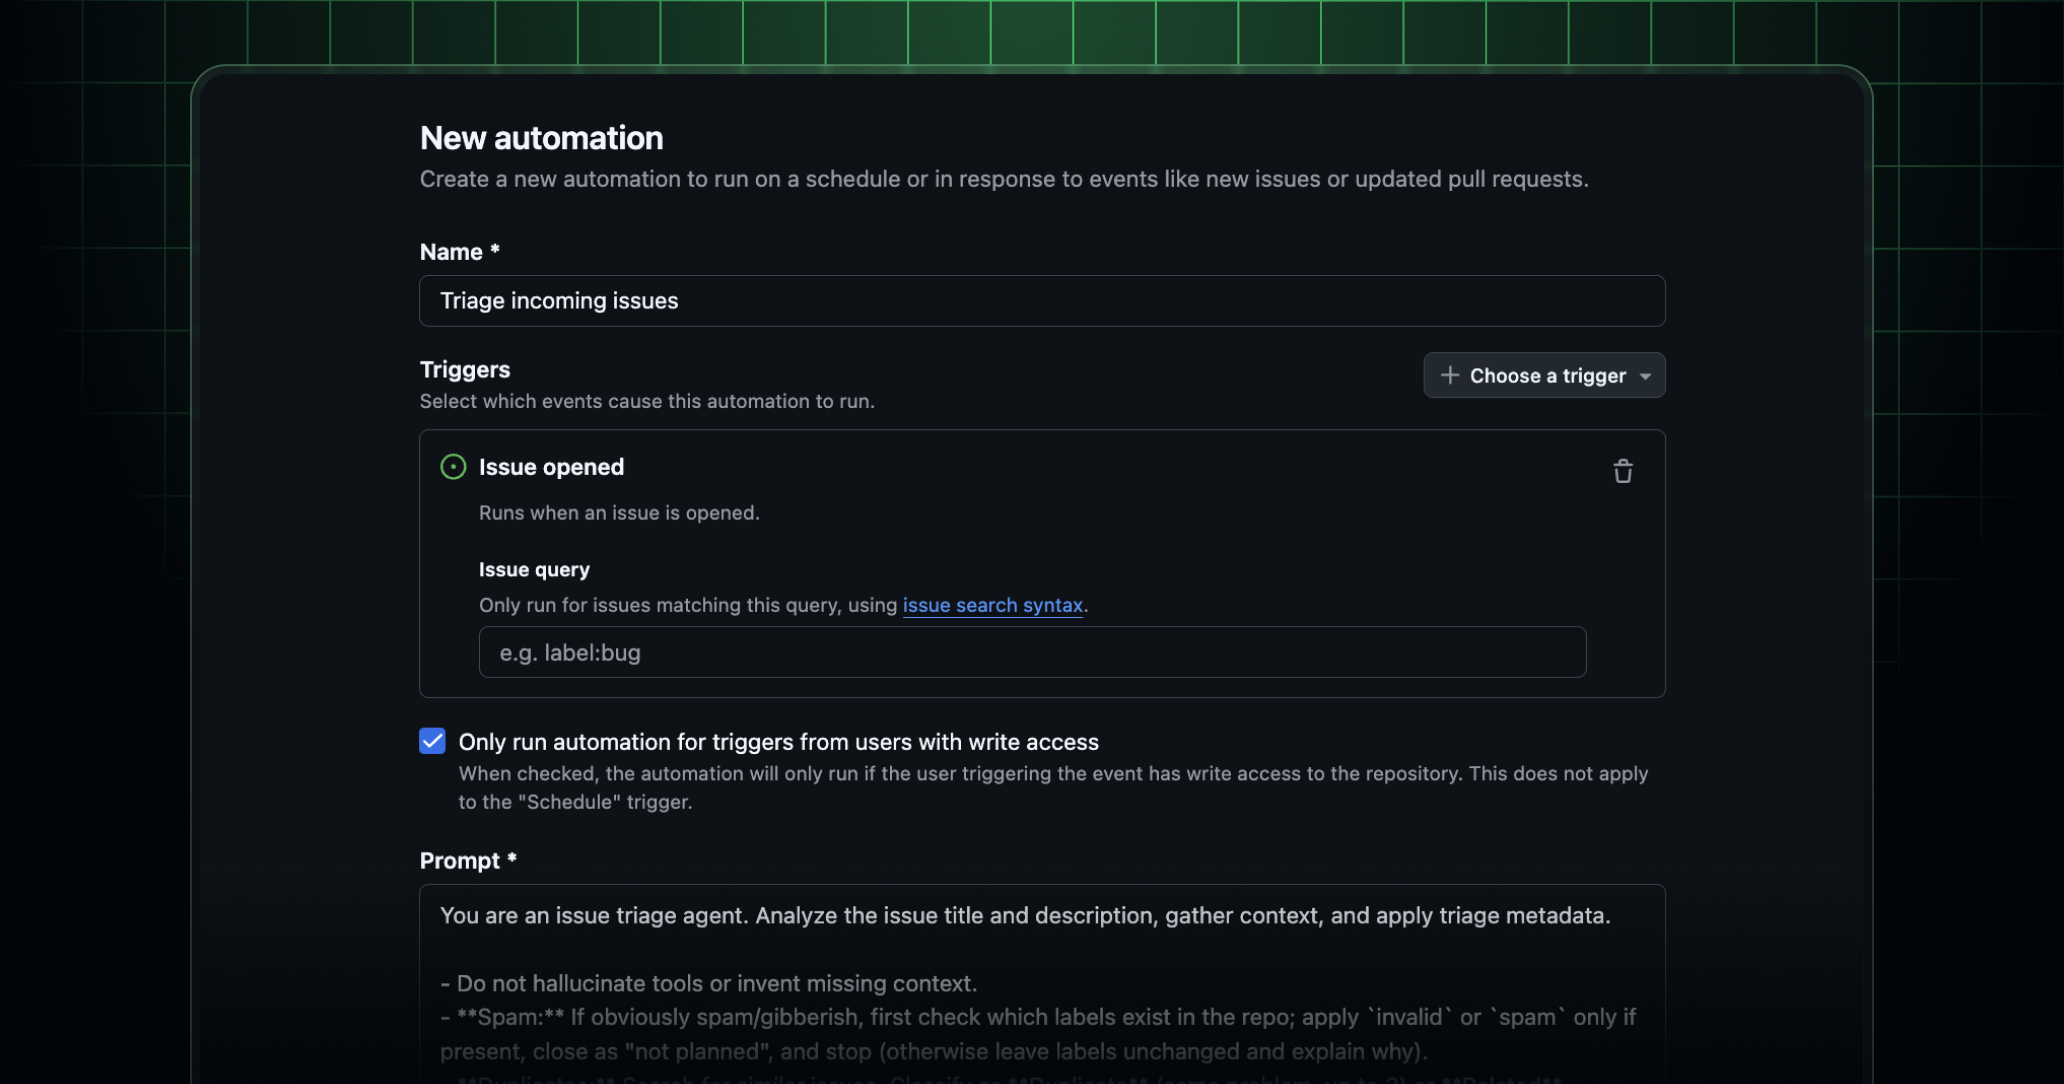
La cosa interessante è che diversi pezzi di questa architettura esistono già nei prodotti che chi sviluppa usa normalmente. GitHub Copilot cloud agent lavora in un proprio ambiente di sviluppo remoto, può ricevere il compito di correggere una GitHub Actions fallita, analizzare il problema, modificare il branch, eseguire test e linter e poi spingere la correzione chiedendo una revisione; da giugno 2026 GitHub permette inoltre di creare automazioni che partono ad intervalli oppure in risposta ad eventi del repository, ed uno degli esempi forniti dalla stessa GitHub è precisamente controllare ogni notte i test falliti sul branch principale, tentare una correzione ed aprire una draft pull request.
Ancora più vicino all'idea di autoriparazione è Agentic Autofix di GitHub per gli alert di code scanning, perché l'agente esplora i file rilevanti, propone una modifica, riesegue CodeQL oppure l'analisi che aveva trovato il problema e, se necessario, itera prima di aprire la pull request. Questo passaggio è importante perché non abbiamo più soltanto un modello che osserva un messaggio del tipo "qui potrebbe esserci una vulnerabilità" ed inventa una correzione plausibile, abbiamo una sorgente automatica del problema che può essere rieseguita DOPO la patch, quindi l'agente dispone di un criterio esterno che gli dice se almeno quella specifica anomalia è stata rimossa.
Google ha portato la stessa logica ancora più esplicitamente dentro il proprio agente Jules, che può lavorare in una VM cloud isolata, aggiornare dipendenze, scrivere test e correggere bug, mentre l'integrazione con Render annunciata alla fine del 2025 collega direttamente il fallimento di un deployment al processo di riparazione, cioè quando un deployment di una pull request di Jules fallisce l'agente riceve i log senza che lo sviluppatore debba copiarli manualmente, li analizza, individua il problema, scrive una correzione ed apre una nuova pull request. Google ha usato per questa funzione proprio l'espressione self-healing deployments, che rende bene l'idea di ciò che sta succedendo, anche se la guarigione non avviene magicamente dentro il server di produzione ma attraverso una nuova iterazione controllata del ciclo di sviluppo.
Anche Codex di OpenAI si è spostato nella stessa direzione, perché un coding agent moderno non lavora più soltanto nella finestra dell'editor ma può ricevere un issue, riprodurre un bug, produrre la correzione, eseguire test e preparare codice pronto per la revisione, mentre le funzioni di lavoro in background permettono di affidargli attività ricorrenti come triage, monitoraggio degli alert e CI/CD. Con Symphony, OpenAI ha inoltre descritto un modello nel quale un orchestratore trasforma una board di progetto in un piano di lavoro continuo per agenti che prendono attività, operano sui repository e restituiscono risultati che gli esseri umani devono poi controllare. A mio parere è proprio questo passaggio dall'agente singolo all'ORCHESTRAZIONE che trasforma l'assistente di coding in infrastruttura di manutenzione.
La sandbox è ciò che separa l'automazione utile dal disastro
Se un agente possiede il permesso di modificare codice ed eseguire comandi, la prima regola sensata è non lasciarlo sperimentare direttamente nell'ambiente che serve gli utenti. La sandbox diventa quindi il luogo nel quale la Self-Healing Codebase può permettersi di sbagliare, perché l'agente clona il repository oppure crea un worktree isolato, installa dipendenze, riproduce il problema, modifica i file, compila ed esegue test senza toccare ciò che sta girando in produzione. Se il tentativo fallisce si può distruggere l'ambiente e ricominciare, mentre se funziona otteniamo una patch, un diff, un insieme di log e risultati riproducibili che possono essere sottoposti alla pipeline normale.
Questo isolamento deve essere molto più serio di una semplice cartella temporanea, perché un agente che esegue comandi può leggere file, aprire connessioni, installare pacchetti ed incontrare contenuti del repository che influenzano il suo comportamento. I sistemi moderni usano quindi macchine virtuali, container, filesystem separati, credenziali a privilegi minimi, firewall ed autorizzazioni esplicite per le azioni più delicate, con una distinzione fondamentale fra ciò che l'agente può fare nella propria area di lavoro e ciò che può fare nel repository centrale oppure nell'infrastruttura. OpenAI descrive esplicitamente questo problema quando parla dei controlli usati per Codex, nei quali sandbox, permessi, approvazioni umane e telemetria servono a stabilire non soltanto COSA l'agente sta facendo ma anche fin dove gli è consentito arrivare.
Ed è interessante vedere che GitHub conserva per impostazione predefinita un'approvazione umana prima di eseguire determinati workflow Actions generati dal coding agent, proprio perché una pipeline CI/CD può avere accesso a token, secret ed autorizzazioni molto più pericolose del codice che stiamo correggendo. Nel 2026 esiste anche l'opzione per saltare questa approvazione e rendere il ciclo più rapido, ma GitHub stessa avverte che il vantaggio va bilanciato con il rischio. Questo dettaglio dice molto più di cento slogan sull'autonomia, perché una codebase che si ripara da sola ha senso soltanto se conosciamo esattamente il PERIMETRO entro il quale può tentare di farlo.
Log, stack trace e dump diventano gli occhi dell'agente
Per correggere un guasto l'agente deve prima riuscire a vederlo, ed è qui che l'osservabilità entra direttamente nell'ingegneria del software agentica. Un errore di compilazione è relativamente semplice, perché contiene file, riga e simbolo coinvolto, mentre un test fallito aggiunge spesso input, output atteso, output ottenuto e stack trace; un crash può invece richiedere core dump, minidump, backtrace, simboli di debug ed informazioni sull'ambiente, mentre un problema distribuito può emergere soltanto mettendo insieme log di più servizi, trace OpenTelemetry, metriche, identificativi di richiesta ed eventi avvenuti qualche secondo prima.
Un agente può essere sorprendentemente bravo a collegare questi indizi perché riesce a leggere contemporaneamente codice, configurazioni e diagnostica, ma non può ricostruire informazioni che il sistema non ha mai registrato. Se un'applicazione scrive soltanto "errore generico" e poi muore, anche il miglior modello parte quasi al buio, mentre se ogni richiesta possiede un correlation ID, gli errori contengono lo stack, la versione esatta del build è nota ed il deployment conserva la provenienza di ogni artefatto, l'agente può risalire dal sintomo al commit che probabilmente lo ha prodotto. La Self-Healing Codebase quindi non rende meno importante l'observability, al contrario la rende ancora più preziosa perché i dati che prima dovevano aiutare una persona alle tre del mattino diventano anche il linguaggio attraverso il quale il software descrive il proprio stato ad un sistema automatico.
Il caso più semplice, una dipendenza cambia e qualcosa si rompe
Immaginiamo una situazione molto comune, perché una libreria viene aggiornata durante un job programmato e la nuova versione rimuove oppure depreca un metodo che il nostro progetto usa in venti punti. La CI installa la nuova dipendenza, il compilatore fallisce e l'agente riceve il log, quindi controlla il lockfile, confronta la versione che funzionava con quella nuova, cerca tutte le chiamate alla vecchia API, legge eventualmente la documentazione disponibile nell'ambiente e prepara una migrazione. A quel punto ricompila, esegue i test unitari ed i test di integrazione e, se tutto torna verde, può creare un commit sul proprio branch ed aprire una pull request che racconta cosa è cambiato e quali verifiche sono state eseguite.
Quello che oggi richiede magari mezz'ora ad uno sviluppatore esperto può quindi accadere mentre nessuno sta guardando, ma il guadagno più grande non è necessariamente la mezz'ora risparmiata, è la LATENZA ORGANIZZATIVA eliminata. Un problema che emerge alle 02:17 non deve aspettare le 09:00 perché qualcuno apra Slack, legga l'allarme, trovi il repository, ricrei l'ambiente e cominci a capire cosa è successo, perché alle 02:20 un agente può avere già iniziato la diagnosi e magari alle 02:35 esiste una patch verificata che aspetta soltanto una decisione umana. Non significa azzerare magicamente ogni downtime, perché un guasto di produzione può dipendere da dati corrotti, infrastruttura, rete, concorrenza oppure fenomeni che i test non riproducono, ma significa comprimere enormemente il Mean Time To Repair quando la causa rientra nel perimetro che l'agente riesce ad osservare e riprodurre.
Il test non dimostra che la patch sia giusta o sicura, dimostra solo ciò che abbiamo saputo testare. Quindi..occhio!
Qui si trova il limite più importante di tutto il concetto, perché un agente potrebbe produrre una modifica che fa tornare verde la pipeline e contemporaneamente introduce un errore che la pipeline non sa vedere. Se un test verifica che una funzione restituisca 200 invece di 500, l'agente potrebbe trovare una scorciatoia assurda che soddisfa quel controllo senza preservare il significato dell'applicazione, oppure potrebbe modificare il test stesso per farlo passare, cosa tecnicamente facilissima se non abbiamo definito regole che glielo impediscono. Un sistema autoriparante è quindi forte quanto i suoi ORACOLI, cioè i meccanismi esterni che stabiliscono se il comportamento è corretto.
Per questo una pipeline destinata agli agenti deve diventare molto più severa di quella che spesso tolleriamo per gli esseri umani, con unit test, integration test, test di regressione, contratti API, analisi statica, controllo delle dipendenze, benchmark dove contano le prestazioni, scanner di sicurezza ed eventualmente canary deployment che osservano il comportamento della nuova versione su una porzione controllata del traffico. Più il sistema vuole concedere autonomia all'agente e più deve aumentare la qualità della verifica indipendente, perché NON POSSIAMO usare lo stesso modello come programmatore, giudice unico ed autorità finale e poi sorprenderci se approva una soluzione che gli sembra ragionevole.
Quando il codice si ripara davvero senza aspettare nessuno?
Esiste comunque una scala di autonomia e non tutti i problemi meritano lo stesso livello di supervisione. Posso permettere ad un agente di correggere automaticamente un errore di formattazione, aggiornare una dipendenza patch, rigenerare un file derivato oppure sistemare un test chiaramente rotto e lasciare che faccia commit su un branch dedicato; posso richiedere una revisione umana per modifiche applicative normali, due approvazioni per autenticazione e pagamenti e vietare completamente cambi automatici a schema del database, infrastruttura di sicurezza o codice che controlla processi fisici. La Self-Healing Codebase non deve quindi essere pensata come un interruttore acceso o spento ma come una MATRICE DI AUTONOMIA nella quale il rischio decide quanta libertà concedere.
In ambienti a rischio basso possiamo perfino chiudere il ciclo quasi completamente, con un evento che avvia l'agente, una patch che passa tutti i gate, un merge automatico ed un deployment canary che viene promosso soltanto se metriche ed error rate rimangono entro soglia; se qualcosa peggiora, il sistema esegue rollback ed apre nuovamente un incidente con tutto il contesto della modifica appena tentata. In altri casi sarà molto più sensato fermarsi alla pull request, ed infatti è proprio qui che si collocano oggi GitHub, Jules e gran parte degli agenti commerciali, che automatizzano moltissimo il lavoro ma lasciano allo sviluppatore il controllo dell'ultimo passaggio. Non è un limite imbarazzante, è un disegno di sicurezza ragionevole.
Il DevOps non scompare ma lavora da un'altra parte
L'idea che questi sistemi rendano inutile il programmatore DevOps mi convince poco, perché in realtà spostano il lavoro verso un livello superiore. Qualcuno deve decidere quali segnali fanno partire un agente, quali repository può modificare, quali comandi può eseguire, quali secret può vedere, quali test rappresentano veramente il comportamento desiderato, quando può aprire una pull request, quando può fare commit, chi deve approvare il merge e cosa succede se la correzione peggiora la produzione. In pratica il DevOps smette progressivamente di essere la persona che interviene manualmente su ogni singolo guasto ripetitivo e diventa colui che PROGETTA IL SISTEMA che decide come i guasti devono essere osservati, riprodotti e riparati.
È un cambiamento molto simile a quello già avvenuto con Infrastructure as Code e CI/CD, perché una volta gli amministratori configuravano server a mano, poi abbiamo iniziato a descrivere l'infrastruttura in file versionati, automatizzando i deployment, mentre adesso stiamo aggiungendo una nuova componente capace non soltanto di eseguire una procedura già scritta ma anche di proporre la procedura mancante quando incontra qualcosa che non avevamo previsto. Questo aumenta enormemente la potenza dell'automazione ma introduce anche una variabilità nuova, perché un agente generativo non è uno script Bash deterministico e può scegliere strade differenti davanti allo stesso problema, quindi audit, tracciabilità e riproducibilità diventano ancora più importanti di prima.
Anche il repository dovrà imparare a parlare con gli agenti
Un'altra conseguenza che si sta vedendo chiaramente è che le codebase migliori per gli agenti non sono necessariamente quelle migliori soltanto per gli esseri umani, perché un agente lavora molto meglio quando trova istruzioni esplicite, comandi di setup affidabili, test veloci, dipendenze riproducibili ed una struttura nella quale è chiaro quali file siano sorgenti e quali generati. File come AGENTS.md, documentazione locale, script di bootstrap, fixture, ambienti containerizzati ed informazioni sulle convenzioni del progetto diventano una specie di interfaccia operativa che spiega all'agente COME deve lavorare prima ancora di dirgli cosa deve cambiare.
OpenAI ha descritto questo approccio con il termine harness engineering, cioè costruire attorno all'agente un'imbracatura di contesto, test e guardrail che gli permetta di lavorare con continuità, ed il concetto secondo me è molto più importante del modello specifico usato in un certo momento. Se cambio modello ma il repository rimane caotico, i test sono intermittenti e per avviare l'applicazione servono diciassette passaggi tramandati oralmente fra colleghi, l'agente continuerà a perdere tempo e commettere errori; se invece una nuova copia del progetto può essere portata ad uno stato funzionante con un comando, i test spiegano bene cosa deve rimanere vero ed ogni failure produce diagnostica utile, allora sia un essere umano sia un agente diventano enormemente più efficaci.
Il rischio nuovo? Una patch perfettamente plausibile ma .. sbagliata
C'è poi un problema che con uno script classico quasi non esiste, perché uno script o sa cosa fare oppure fallisce, mentre un agente può inventare una soluzione coerente, elegante ed apparentemente giusta che in realtà modifica il comportamento in un modo inatteso. Può interpretare male un requisito, rimuovere una validazione che considera superflua, scegliere una versione di dipendenza incompatibile con un cliente che non vede nei test oppure correggere il sintomo invece della causa. Per questo non basta conservare il diff finale, dobbiamo registrare anche i comandi eseguiti, i risultati dei test, l'ambiente, il modello utilizzato, i permessi concessi ed idealmente la catena di eventi che ha portato alla modifica.
Questa telemetria serve per capire cosa è successo quando tutto va male, ma serve anche per misurare se l'automazione conviene davvero, perché possiamo calcolare quante riparazioni vengono proposte, quante passano i test, quante vengono accettate senza modifiche, quante vengono respinte, quante introducono regressioni e quanto tempo medio risparmiano. Se un agente genera cento patch e novanta devono essere riscritte, abbiamo creato rumore invece di manutenzione autonoma; se invece risolve in modo affidabile categorie ristrette e ripetitive di problemi, allora possiamo progressivamente allargare il suo perimetro, che è probabilmente il modo più sensato con cui queste tecnologie entreranno nelle aziende serie.
Dal pair programming alla medicina preventiva del software
Per me la parte più affascinante delle Self-Healing Codebases è proprio il cambio di prospettiva, perché per anni abbiamo chiesto all'AI "scrivimi questa funzione", poi "modifica questi file" ed ora iniziamo a poterle dire implicitamente "mantieni sano questo sistema entro queste regole". La differenza è enorme, perché nel primo caso il lavoro comincia quando un essere umano formula una richiesta, mentre nel secondo esiste un processo continuo che osserva eventi, individua degrado, propone manutenzione e reagisce quando qualcosa rompe l'equilibrio del progetto.
Questo non porterà domani mattina a software immortale che non possiede più bug, ed anzi creerà una nuova categoria di problemi legati ad agenti, permessi, falsi positivi, patch scorrette e costi computazionali, però il meccanismo di base ormai esiste ed è già riconoscibile nei prodotti reali del 2026. La vera rivoluzione non consiste più nell'avere una macchina che scrive codice 650 volte più velocemente del più veloce di noi, ma consiste nell'avere una macchina che RIMANE ACCANTO AL CODICE quando noi abbiamo smesso di guardarlo, quando noi nemmeno ci ricorderemo più di aver guidato la sua redazione, controllando i segnali che gli abbiamo insegnato a leggere e tentando una riparazione quando qualcosa si rompe, preparando per noi una soluzione verificata prima ancora che il problema finisca nella coda del mattino successivo. Solo così usare l'AI per programmare può avere un senso. Tutto il resto è fuffa. Non funzionerà mai.


Commenti
Nessun commento, per ora.
Per commentare serve un accesso. Qui siamo tutti tecnici e colleghi!
Accedi per commentare