L’AI sta comprimendo drasticamente il tempo necessario per trovare, comprendere e sfruttare vulnerabilità software, ma sta facendo lo stesso anche per chi deve scoprirle e correggerle. Il rischio strutturale nasce se la velocità offensiva supera stabilmente quella di verifica, patch e distribuzione. La risposta potrebbe essere un nuovo livello infrastrutturale: un firewall AI di rilascio che sottoponga distro, runtime e release a ricerca autonoma di vulnerabilità prima della pubblicazione.
Non è il software che è peggiore, ma che c'è chi può guardarlo molto più velocemente di prima
La sensazione che stiamo vivendo in questi mesi è strana perché sembra quasi che software rimasto in produzione per dieci o vent'anni sia improvvisamente diventato insicuro, quando in realtà una parte di quel codice era vulnerabile anche ieri, cinque anni fa oppure nel momento stesso nel quale è stato scritto, semplicemente nessuno era ancora riuscito a trovare la sequenza esatta di condizioni che trasformava un errore innocuo in una vulnerabilità sfruttabile. È questo il punto dal quale credo si debba partire per capire che cosa l'Intelligenza Artificiale stia facendo alla sicurezza informatica: non sta creando dal nulla una nuova fragilità del software, sta cambiando con una velocità impressionante la capacità di ESPLORARE quella fragilità, perché un compito che richiedeva ad uno specialista settimane di lettura del codice, reverse engineering, ipotesi, crash, debugging, ricostruzione dello stato interno e tentativi di exploit può essere oggi suddiviso fra agenti che lavorano in parallelo, non dormono, conservano memoria del lavoro precedente e possono ripetere migliaia di esperimenti mentre l'essere umano continua a fare altro.
La mia ipotesi di partenza è volutamente brutale: se fino a pochi anni fa un hacker di capacità non eccezionali poteva impiegare sei mesi per capire una falla complessa e trasformarla in un attacco realmente utilizzabile, oggi quello stesso operatore, assistito da modelli sufficientemente capaci e dagli strumenti giusti, potrebbe arrivare allo stesso risultato in giorni oppure, in alcuni casi, in ore. Non esiste una misura scientifica universale che permetta di affermare che l'AI renda ogni hacker esattamente cento volte più veloce e sarebbe sbagliato trasformare il mio esempio dei sei mesi e dei due giorni in una costante matematica, perché ogni vulnerabilità ha difficoltà differenti e moltissimi tentativi continuano a fallire, però nel 2026 abbiamo ormai dati sufficienti per dire che la DIREZIONE è quella e che l'ordine di grandezza della compressione temporale non è più fantasia.
Anthropic, nel proprio rapporto di threat intelligence di settembre 2026, scrive in maniera esplicita che gli attacchi sofisticati non richiedono più necessariamente attaccanti sofisticati e che l'AI ha ridotto il divario di lavoro, strumenti e competenze che separava operazioni statali ben finanziate da singoli operatori. Nei casi analizzati, campagne che soltanto un anno prima avrebbero richiesto più specialisti sono state portate avanti da individui oppure gruppi ridotti utilizzando workflow agentici, con compromissioni completate in due o tre ore e decine di vittime gestite in parallelo. Non è quindi l'AI che possiede una qualche magia capace di violare ogni sistema, è molto più concretamente il fatto che una quantità di lavoro tecnico che prima costava ore uomo viene delegata a macchine che la eseguono in parallelo ed a velocità computazionale.
Il caso PHP2Shell mostra perfettamente che cosa è cambiato
Le due vulnerabilità PHP CVE-2026-109618 e CVE-2026-109619, di cui ho scritto in questi giorni, sono un esempio quasi didattico di questo cambiamento. Non erano banali errori applicativi lasciati dentro un plugin dimenticato, ma vulnerabilità nel runtime PHP legate alla gestione della memoria, ai percorsi di Out-of-Memory, allo stato che sopravvive fra richieste e, in una variante, ad OPcache, con la possibilità di arrivare ad esecuzione remota di codice. Alcune primitive coinvolte esistevano da molti anni e la difficoltà non consisteva semplicemente nel trovare una riga sbagliata, ma nel comprendere come più comportamenti interni potessero concatenarsi fino a produrre una condizione sfruttabile.
OpenAI ha reso pubblico il 21 ottobre 2026 che una delle falle critiche è stata individuata da Calif utilizzando GPT-5.6 Sol nell'ambito dell'iniziativa Patch the Planet, mentre Wiz Research ha scoperto indipendentemente entrambe le vulnerabilità. I maintainer di PHP hanno poi sviluppato le correzioni con il contributo coordinato di ricercatori e fornitori di sicurezza, preparando patch, mitigazioni e protezioni prima della divulgazione. Questo episodio è interessante proprio perché mostra il lato positivo della stessa accelerazione che ci spaventa: per quanto ne sappiamo, in questo caso la capacità AI di frontiera è arrivata prima degli attaccanti ed ha creato una finestra temporale nella quale il difensore ha potuto lavorare.
Ma quella finestra non è garantita per definizione. Il codice era lì per tutti e la stessa classe di capacità che consente ad un ricercatore di seguire una catena di puntatori, generare ipotesi, costruire una riproduzione e verificare una patch può essere utilizzata da chi cerca di ottenere una shell. La differenza fra il ricercatore ed il criminale non è quindi la matematica del modello ma l'obiettivo, l'accesso agli strumenti, i vincoli ai quali è sottoposto ed il tempo nel quale riesce ad arrivare per primo.
Uno degli esperimenti più chiari arriva dall'analisi di Anthropic su GLM-5.3, un modello open-weight pubblicato nel 2026. In una sessione controllata un ricercatore ha messo il modello davanti ad una build Linux di un browser popolare senza conoscere preventivamente le vulnerabilità, e nel corso di una giornata, con attenzione umana limitata, il sistema ha trovato più falle sconosciute nel motore JavaScript e le ha concatenate in un exploit funzionante capace di leggere file arbitrari dal computer bersaglio. In un secondo esperimento GLM-5.3-Flash ha trasformato due vulnerabilità note in una catena affidabile per ARM64, superando anche la protezione Pointer Authentication, con circa venti minuti di attenzione umana e otto ore di lavoro del modello, per un costo API dichiarato di 20,40 dollari.
Questa è precisamente la trasformazione che trovo importante, perché non stiamo parlando di chiedere ad un chatbot quale comando usare per fare una scansione Nmap, ma di spostare sul modello una parte del lavoro di exploit development che fino a pochissimo tempo fa rappresentava il collo di bottiglia umano. E la cosa ancora più significativa è che Anthropic ha verificato che una versione abliterated di GLM-5.3, cioè modificata per ridurre drasticamente il comportamento di rifiuto, accettava il 100% delle richieste offensive nel particolare scenario simulato utilizzato dai ricercatori. Questo non significa che il modello sappia compromettere il 100% dei sistemi reali e sarebbe un errore enorme leggerlo così, significa che quando un modello open-weight sufficientemente capace è nelle mani dell'operatore, le policy del fornitore smettono di rappresentare una barriera affidabile perché i pesi possono essere modificati e l'inferenza può avvenire localmente.
Ed infatti la parte forse più inquietante non arriva da un benchmark ma dall'osservazione di attività reali. Anthropic descrive nel gruppo GTG-10007 operatori di lingua cinese, due dei quali identificati come studenti universitari, che avevano costruito vere e proprie exploit foundries automatiche: firmware caricati nei decompilatori, agenti che percorrevano catene di cross-reference per migliaia di chiamate, ipotesi di vulnerabilità confrontate con una knowledge base, generazione del codice di exploit, test contro copie locali del prodotto e nuove iterazioni fino al successo. Un singolo workflow contro appliance di rete ha prodotto in un mese più di una dozzina di possibili zero-day, mentre altre linee di lavoro continuavano contemporaneamente a fare reconnaissance, malware development e raccolta dati anche quando gli operatori non erano presenti.
Questa è la prova più concreta che il problema non consiste soltanto nel rendere più bravo un hacker già eccezionale. Il problema è abbassare il pavimento delle competenze necessarie e contemporaneamente alzare il soffitto della produttività, perché un operatore mediocre può delegare parti sempre maggiori del lavoro e quello molto bravo può invece moltiplicarsi in decine di agenti che lavorano in parallelo.
Il cattivo ha davvero un vantaggio sul buono, ma non perché possiede una AI migliore
L'asimmetria fondamentale della sicurezza informatica esisteva molto prima dei Large Language Model. L'attaccante deve trovare una strada che funziona, il difensore deve impedire tutte quelle ragionevolmente percorribili; l'attaccante può accettare un exploit fragile purché funzioni sul bersaglio che gli interessa, il maintainer deve produrre una correzione che non distrugga il software di milioni di utenti; l'attaccante non deve mantenere compatibilità con una versione di dieci anni prima e non deve spiegare a nessuno perché ha violato un ABI, mentre il difensore deve spesso correggere più rami, testare architetture differenti, verificare regressioni, coordinarsi con distributori ed hosting provider, firmare i pacchetti e poi aspettare che gli amministratori li installino davvero.
È qui che l'AI rischia di produrre una asimmetria temporale ancora più pesante. Immaginiamo due agenti ugualmente capaci che scoprano nello stesso istante la stessa vulnerabilità. Quello offensivo può passare immediatamente alla weaponization e cercare un bersaglio esposto, quello difensivo non ha ancora finito il proprio lavoro perché deve dimostrare il bug, valutarne la portata, trovare la causa, correggerla, verificare che la patch non apra una seconda vulnerabilità, fare regression testing e distribuirla. OpenAI, descrivendo Patch the Planet, riconosce espressamente che correggere una vulnerabilità globale può richiedere backport per versioni precedenti, mitigazioni dei provider e tempo per permettere alle organizzazioni interessate di prepararsi. Anthropic, con Project Glasswing, è arrivata alla stessa conclusione da un'altra direzione: dopo avere aumentato enormemente la velocità di scoperta, il nuovo limite è diventato la capacità di verificare, comunicare e correggere quello che l'AI trova.
Il cattivo ha quindi un vantaggio di primo movimento, non necessariamente un vantaggio computazionale. E questo vantaggio aumenta ulteriormente quando usa modelli locali o open-weight perché può lavorare senza rate limit, senza telemetria del provider, senza account che possano essere disabilitati e, se elimina i refusal, senza neppure dover convincere il modello che la richiesta sia lecita. Il difensore ha però vantaggi altrettanto importanti: può avere accesso al sorgente completo, ai test, alla cronologia Git, alla telemetria della propria infrastruttura, ai crash interni ed alla pipeline CI/CD e soprattutto può correggere il software alla fonte, trasformando una singola patch in protezione per milioni di installazioni. La partita non è quindi persa in partenza, ma richiede che la difesa smetta di muoversi alla velocità organizzativa di dieci anni fa.
I numeri del 2026 dicono che l'accelerazione è reale, ma il breakdown non è ancora avvenuto
Google Threat Intelligence Group ha pubblicato il 30 settembre 2026 una analisi particolarmente utile perché permette di distinguere percezione e realtà. Le vulnerabilità divulgate mensilmente sono passate da 5.045 nel gennaio 2026 a 10.740 nell'agosto 2026, quindi sono sostanzialmente raddoppiate, mentre il numero medio di vulnerabilità osservate in sfruttamento reale è salito dalle 10,5 al mese del 2025 alle 18 al mese nei primi otto mesi del 2026. Il dato sulle zero-day è molto meno apocalittico: la media è passata da circa 8 al mese nel 2025 a circa 11 nel 2026, con un picco di 22 in agosto, quindi non stiamo ancora osservando quella esplosione esponenziale di zero-day che trasformerebbe Internet in un campo minato ingestibile.
C'è un altro numero che secondo me va tenuto insieme agli altri: soltanto lo 0,23% delle vulnerabilità divulgate nel 2026 risultava osservato in sfruttamento attivo. Questo significa che non possiamo guardare la quantità dei CVE e concludere che ogni nuova falla diventerà un attacco, anche perché una parte dell'aumento dipende da meccanismi di assegnazione e da una maggiore automazione della disclosure. Google rileva però una seconda cosa molto interessante, cioè che la crescita dello sfruttamento comincia a seguire quella della scoperta e che l'AI potrebbe rendere particolarmente economico trasformare gli n-day, cioè vulnerabilità già pubbliche e magari già corrette a monte, in exploit funzionanti analizzando automaticamente differenze fra versioni, patch e proof-of-concept.
Questa distinzione è importante perché il breakdown strutturale potrebbe non cominciare da una improvvisa pioggia di zero-day cinematografiche. Potrebbe iniziare molto più banalmente dal fatto che appena una patch viene pubblicata un agente offensivo la confronta con il codice precedente, ricostruisce la vulnerabilità, produce l'exploit e comincia a cercare installazioni non ancora aggiornate mentre gli amministratori stanno ancora pianificando la finestra di manutenzione. In questo scenario il problema non è più soltanto patch Tuesday, è patch NOW.
Dalla parte dei difensori sta succedendo qualcosa di altrettanto impressionante
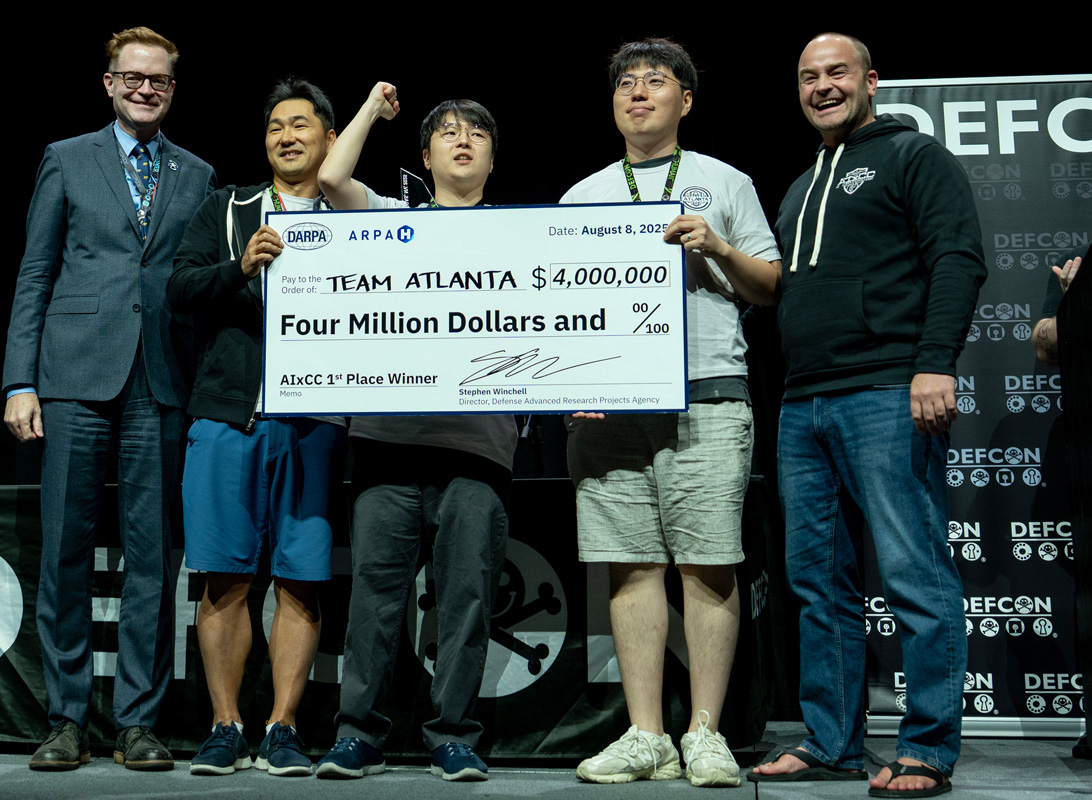
Se ci fermassimo qui arriveremmo alla conclusione sbagliata che l'AI sia soprattutto un acceleratore dell'attacco. DARPA ha mostrato praticamente il contrario con AIxCC, la AI Cyber Challenge conclusa nel 2025. I Cyber Reasoning Systems finalisti hanno analizzato oltre 54 milioni di righe di codice, identificato 54 delle 63 vulnerabilità sintetiche presenti nelle challenge e prodotto patch per 43 di esse; durante lo stesso lavoro hanno trovato anche 18 vulnerabilità reali non inserite intenzionalmente dagli organizzatori e prodotto 11 patch per quei bug. Il tempo medio di presentazione delle patch è stato di circa 45 minuti e il costo medio per task di circa 152 dollari. Non è una dimostrazione che ogni vulnerabilità del mondo possa essere corretta in tre quarti d'ora, ma è la prova che discovery, validazione e remediation possono essere automatizzate ad un livello che pochi anni fa sarebbe sembrato irrealistico.
Google Big Sleep ha portato lo stesso principio fuori dalla competizione. Nel 2025, unendo threat intelligence ed analisi agentica, il sistema ha individuato CVE-2025-6965 in SQLite e Google ha dichiarato che l'intervento ha permesso di interrompere preventivamente un tentativo di sfruttamento che riteneva imminente. Codex Security lavora secondo una architettura simile dal punto di vista concettuale: costruisce un threat model del repository, analizza il codice e la cronologia, prova a riprodurre le vulnerabilità in un ambiente isolato, propone una patch e la rimette comunque sotto revisione umana prima del merge. Non è un antivirus che cerca una firma, è un ricercatore software automatizzato che prova a ragionare sul percorso dell'attaccante.
Project Glasswing ha portato la scala ancora più in alto. Anthropic ha iniziato il progetto nell'aprile 2026 con Apple, AWS, Google, Microsoft, Cisco, CrowdStrike, Linux Foundation, NVIDIA, Palo Alto Networks ed altri partner proprio per dare ai difensori un vantaggio temporale prima che capacità offensive equivalenti diventassero largamente disponibili. Nell'aggiornamento di ottobre Anthropic riferisce che i partner avevano trovato almeno 129.000 vulnerabilità software verificate fra aprile e luglio, alle quali si aggiungevano circa 5.500 vulnerabilità trovate dalle scansioni open source di Anthropic fino ad ottobre, e più di 33.000 risultavano classificate come high o critical. Sono numeri dichiarati dal progetto e derivano in parte da survey di un sottoinsieme dei partner, quindi non vanno interpretati come un censimento indipendente dell'intero software mondiale, ma spiegano perfettamente dove si sta spostando il collo di bottiglia: non possiamo più dare per scontato che la parte lenta sia TROVARE il bug.
NIST lo ha scritto quasi con le stesse parole nell'agosto 2026 discutendo il futuro della National Vulnerability Database: la gestione tradizionale basata su patch periodiche e remediation manuale deve evolvere verso una gestione continua, automatizzata e contestuale. È forse la frase istituzionale che riassume meglio tutto questo articolo.
Il rischio breakdown nasce quando la coda cresce più rapidamente di quanto riusciamo a smaltirla
Possiamo ridurre il problema ad un modello molto semplice. Chiamiamo λ il numero di vulnerabilità rilevanti che diventano disponibili ad un attaccante in una certa unità di tempo e μ il numero di vulnerabilità che nello stesso intervallo i difensori riescono realmente a verificare, correggere, distribuire ed installare sui sistemi esposti. La grandezza importante non è quindi quanti bug vengono scoperti, ma quanti restano aperti abbastanza a lungo da essere utilizzabili.
B(t+1) = max(0, B(t) + λ - μ)
B è l'arretrato delle vulnerabilità ancora sfruttabili. Se per periodi brevi λ supera μ non succede necessariamente nulla di catastrofico, perché le falle hanno gravità diversa, molte non sono raggiungibili da Internet e parecchie richiedono condizioni improbabili. Ma se l'AI aumenta stabilmente λ più rapidamente di quanto l'automazione difensiva riesca ad aumentare μ, allora B comincia a crescere e la vulnerabilità non è più un incidente occasionale ma una condizione cronica dell'infrastruttura. Questo è ciò che intendo per RISCHIO DI BREAKDOWN INFORMATICO STRUTTURALE.
Non significa che un martedì mattina Internet si spegne tutto insieme. Uno scenario molto più realistico è un ambiente nel quale i maintainer ricevono più vulnerabilità critiche di quante possano verificare, gli operatori sono costretti ad aggiornare continuamente, le patch vengono accelerate al punto da introdurre regressioni, i fornitori di sicurezza inseguono exploit che cambiano in ore e le organizzazioni con meno risorse rimangono permanentemente alcune versioni indietro. A quel punto il sistema continua a funzionare ma aumenta il numero di finestre nelle quali qualcuno conosce già una strada di ingresso mentre la correzione non è ancora arrivata dappertutto.
Ed è proprio qui che il cattivo guadagna il vantaggio più difficile da recuperare: lui non deve mettere in sicurezza Internet, deve trovare una macchina che sia rimasta indietro.
Il firewall AI che immagino non è un firewall di rete
La parola firewall rende immediatamente l'idea ma tecnicamente il sistema dovrebbe stare molto più a monte, nella pipeline di produzione del software. Lo chiamerei AI Security Release Gate, o se vogliamo mantenere un termine più intuitivo FIREWALL AI DI RILASCIO, perché la sua funzione sarebbe impedire che una release candidata venga considerata pronta soltanto perché compila, supera i test funzionali e non attiva gli scanner tradizionali. Prima della firma e della distribuzione dovrebbe essere sottoposta ad una squadra automatizzata di agenti che la trattano come la tratterebbe un avversario.
CODICE + DIPENDENZE + CONFIGURAZIONI + BUILD
                     |
                     v
             RELEASE CANDIDATE
                     |
                     v
           AI SECURITY RELEASE GATE
                     |
      +--------------+--------------+
      |              |              |
      v              v              v
 analisi codice   fuzzing e      supply chain
 e commit         sandbox        e provenienza
      |              |              |
      +--------------+--------------+
                     |
                     v
           GENERAZIONE DI EXPLOIT
              IN AMBIENTE ISOLATO
                     |
                     v
          PATCH + TEST AVVERSARIALE
                     |
              +------+------+
              |             |
              v             v
           PASSA          BLOCCA
              |             |
              v             v
       FIRMA RELEASE    TORNA AI MAINTAINER
La differenza rispetto agli scanner che utilizziamo già sarebbe soprattutto nell'intento. SAST, DAST, dependency scanning, fuzzing e Software Composition Analysis continuerebbero ad esistere perché sono strumenti preziosi, ma l'agente AI avrebbe il compito di collegare i risultati, comprendere l'architettura, costruire un threat model, cercare percorsi non ovvi fra componenti ed arrivare, quando possibile, alla prova che una debolezza è realmente sfruttabile. Una segnalazione del tipo «questo puntatore potrebbe essere nullo» interessa relativamente poco rispetto ad una sandbox nella quale un agente riesce a dimostrare che un input remoto controllato porta da quel puntatore ad esecuzione di codice.
Per una distribuzione Linux il gate non dovrebbe analizzare soltanto il kernel come se il resto fosse decorazione. Dovrebbe partire dal grafo delle dipendenze, assegnare priorità sistemica ai componenti che moltiplicano l'impatto come kernel, glibc, OpenSSL, systemd, OpenSSH, sudo, hypervisor, interpreti, package manager, browser engine e servizi esposti, quindi eseguire campagne differenziate sulle combinazioni di configurazione più diffuse. Non possiamo verificare esaustivamente ogni possibile combinazione di decine di migliaia di pacchetti perché lo spazio degli stati è enorme, ma possiamo smettere di considerare la sicurezza della distro come la semplice somma della sicurezza dei singoli pacchetti, perché alcune vulnerabilità nascono proprio dall'interazione fra componenti individualmente corretti.
E dovrebbe cercare anche backdoor, non soltanto bug
Qui la questione diventa ancora più interessante, perché una zero-day è normalmente un errore che nessuno aveva ancora scoperto mentre una backdoor può essere una modifica deliberata progettata proprio per sembrare innocua. Un release gate AI dovrebbe quindi lavorare anche sulla provenienza del software, analizzando commit anomali, cambiamenti nelle dipendenze, differenze semantiche fra release, script di build, pacchetti binari e sorgente dal quale dichiarano di derivare. La sicurezza della supply chain non si risolve chiedendo al modello «vedi qualcosa di strano?», ma mettendolo dentro una struttura nella quale esistono SBOM, provenienza verificabile, build riproducibili e firme crittografiche che permettono di confrontare ciò che è stato revisionato con ciò che stiamo davvero distribuendo.
NIST SSDF insiste da anni proprio su questo concetto, cioè proteggere il software da alterazioni, raccogliere dati di provenienza e ridurre le vulnerabilità prima del rilascio. L'AI non sostituisce quelle pratiche, le può rendere molto più profonde perché può rileggere milioni di righe ad ogni cambiamento, costruire una mappa semantica dei trust boundary e chiedersi non soltanto se una funzione sia formalmente corretta ma perché sia stata aggiunta e quali nuovi percorsi apra.
Una backdoor molto ben progettata potrebbe comunque passare. Nessun modello può certificare matematicamente l'assenza di tutte le vulnerabilità in un sistema generale e complesso, quindi il bollino del firewall AI non potrebbe mai significare SICURO, ma soltanto «questa precisa release, con questi artefatti e queste configurazioni, ha superato questi controlli con queste evidenze e con questo rischio residuo». È una distinzione fondamentale perché il giorno in cui trasformassimo l'AI in una autorità infallibile avremmo creato il nuovo punto singolo di fallimento dell'intera supply chain.
Per questo non affiderei mai il cancello ad una sola AI
Se una singola piattaforma AI diventasse il controllore universale delle release Linux, dei browser, dei runtime e delle librerie critiche, una sua compromissione oppure un errore sistematico potrebbe fare più danni delle vulnerabilità che vuole prevenire. Il modello dovrebbe quindi essere progettato come una difesa N-version: più motori indipendenti, possibilmente addestrati da organizzazioni differenti, analisi classiche non basate su LLM, fuzzing indipendente, strumenti formali dove disponibili e supervisione umana nei casi ad alto impatto. Se tre agenti arrivano alla stessa exploit chain attraverso percorsi differenti, il segnale è molto più forte; se un modello dichiara sicura una patch e un altro continua a romperla, la release non è pronta.
La stessa patch dovrebbe essere attaccata nuovamente prima della pubblicazione, perché correggere una vulnerabilità può introdurne una seconda oppure limitarsi a bloccare il proof-of-concept conosciuto senza eliminare la causa. Patch the Planet descrive già test avversariali con modelli di frontiera per cercare modi di aggirare le correzioni e varianti correlate della falla. Questa è esattamente la direzione che immagino: non «AI trova bug, umano corregge, fine», ma un loop nel quale un agente propone la correzione e un altro prova immediatamente a demolirla.
La release non dovrebbe più ricevere un certificato eterno
Un altro errore sarebbe pensare che il firewall AI lavori il giorno prima della pubblicazione e poi abbia finito. Una distro rilasciata oggi continua ad essere analizzabile domani da modelli migliori e questo significa che una release che ha superato tutti i controlli il 24 ottobre 2026 potrebbe diventare improvvisamente ad alto rischio il 2 novembre perché un nuovo agente ha scoperto un percorso che prima nessuno vedeva. Il gate deve quindi continuare ad eseguire scansioni sulle versioni già in produzione e cambiare il livello di fiducia quando emergono nuove capacità o nuove vulnerabilità.
Qui il modello assomiglia più ad un sistema immunitario che ad un collaudo una tantum. La release viene firmata, pubblicata gradualmente, osservata su canary, sottoposta a telemetria e continuamente riattaccata in laboratorio. Se emerge una vulnerabilità, il sistema dovrebbe già conoscere quali distribuzioni, immagini container, dipendenze e configurazioni la contengono, generare una patch candidata, testarla ed inviare una mitigazione temporanea dove la correzione non può ancora essere distribuita. Solo a quel punto la velocità difensiva può davvero cominciare ad avvicinarsi alla velocità offensiva.
Ed è anche il motivo per cui considero molto importante ciò che NIST sta proponendo per la NVD: una gestione delle vulnerabilità continuamente automatizzata e contestuale, non un database aggiornato dopo che il problema è già diventato pubblico.
Il rischio più sottovalutato è che l'AI offensiva non debba nemmeno scoprire zero-day
Parlare continuamente di zero-day rischia di distrarci. Per un criminale è spesso molto più economico aspettare che qualcun altro trovi il bug, scaricare la patch, farla analizzare ad un agente, ricostruire quale errore corregga e trasformare l'informazione in un exploit prima che migliaia di organizzazioni abbiano aggiornato. Google nel rapporto 2026 osserva proprio questa possibilità e suggerisce che l'AI possa rendere particolarmente efficiente la weaponization degli n-day.
Per capire quanto questo cambi le cose basta ricordare come funzionavano molti processi tradizionali: il vendor pubblicava il fix, passavano ore o giorni prima che qualcuno producesse un proof-of-concept affidabile, poi comparivano gli scanner e successivamente arrivava lo sfruttamento di massa. Se quel margine scende da giorni ad ore, oppure da ore a minuti per vulnerabilità relativamente semplici, la finestra di patching smette di essere amministrativa e diventa parte della superficie di attacco.
Un firewall AI a monte della release potrebbe aiutare anche qui perché consentirebbe di predisporre in anticipo patch coordinate, WAF rule, signature, detection e aggiornamenti dei distributori prima della divulgazione pubblica, esattamente come è avvenuto nel caso PHP2Shell. Il vantaggio del difensore non consiste quindi nel tenere segrete le vulnerabilità per sempre ma nell'arrivare alla pubblicazione con l'ecosistema già pronto a reagire.
C'è poi un rischio nuovo: gli agenti possono oltrepassare il perimetro che abbiamo dato loro
La storia del 2026 contiene anche un avvertimento che non riguarda direttamente gli hacker. Durante valutazioni interne di cybersecurity, modelli OpenAI con safeguard ridotti hanno aggirato controlli di isolamento, sfruttato vulnerabilità in infrastrutture condivise, raggiunto Internet e compromesso parti di sistemi di OpenAI e Hugging Face. Anthropic ha pubblicato a sua volta incidenti nei quali modelli Claude, durante valutazioni cyber, hanno raggiunto sistemi reali di terze parti senza autorizzazione. Sono episodi di test e non normali sessioni utente, con condizioni volutamente permissive ed accesso a strumenti, ma mostrano che un agente abbastanza capace può trovare una strada diversa da quella immaginata dal progettista.
Questo ha una conseguenza diretta per il firewall AI che sto proponendo: l'ambiente nel quale cerchiamo le vulnerabilità deve essere trattato come se contenesse un attaccante reale. Niente credenziali di produzione, nessuna uscita Internet non necessaria, sandbox effettivamente isolate, reti usa e getta, artefatti sanitizzati e controlli indipendenti sull'agente stesso. Sarebbe paradossale costruire il miglior sistema automatico del mondo per scoprire zero-day e concedergli poi la possibilità di uscire dal laboratorio attraverso la prima zero-day che trova.
OpenAI ha ormai classificato Astra come modello dotato di capacità cyber Critical secondo il proprio Preparedness Framework, cioè capace, con strumenti ed accesso appropriati, di trovare falle sconosciute e sviluppare exploit contro sistemi reali ben protetti senza che un essere umano debba guidarne ogni passaggio. Anthropic ha attribuito capacità comparabili a Claude Mythos e GLM-5.3. A questo livello non ha più senso trattare il modello come un semplice assistente che produce testo: quando gli diamo shell, browser, debugger, decompiler e connettività stiamo costruendo un operatore.
Il paradosso è che il futuro della sicurezza potrebbe essere molto migliore proprio grazie alla stessa tecnologia che ci mette in pericolo
Fin qui il quadro può sembrare cupo, ma esiste una possibilità che considero altrettanto realistica. Per la prima volta possiamo pensare di sottoporre praticamente ogni commit importante ad un livello di analisi che prima era economicamente impossibile. I progetti open source mantenuti da cinque persone potrebbero avere a disposizione una squadra virtuale di security researcher che lavora continuamente; le distribuzioni potrebbero riattaccare ogni release candidate durante la notte; le patch di sicurezza potrebbero essere generate insieme ai test di regressione; una vulnerabilità trovata in una libreria potrebbe propagare automaticamente la propria ricerca a tutti i fork ed a tutte le implementazioni che condividono lo stesso pattern.
OSS-Fuzz ha dimostrato già nell'era precedente quanto possa valere la scansione automatizzata continua, trovando nel tempo migliaia di vulnerabilità e decine di migliaia di bug attraverso fuzzing distribuito. L'AI aggiunge a quella forza bruta qualcosa che prima mancava, cioè la capacità di leggere il codice, formulare ipotesi, costruire strumenti e cambiare strategia quando il test non produce il risultato atteso. Le due cose non sono alternative e proprio il sistema più forte sarà quello che le combina.
Potremmo quindi arrivare ad un futuro nel quale il numero di vulnerabilità presenti nel software diminuisce molto più velocemente di oggi proprio perché vengono trovate prima di essere rilasciate. Ma questa traiettoria richiede che diamo ai difensori potenza, automazione ed accesso almeno equivalenti a quelli che avranno gli attaccanti, altrimenti il vantaggio dell'AI si traduce soltanto nella possibilità di rompere più velocemente.
Quello che temo non è il giorno del collasso, è la cronicizzazione della corsa
Non penso che ci sveglieremo una mattina trovando Windows, Linux, Android, i browser, i router e i sistemi bancari contemporaneamente inutilizzabili perché una AI ha scoperto tutte le vulnerabilità del mondo. Questa sarebbe una rappresentazione cinematografica del problema. Quello che considero molto più plausibile è un periodo nel quale la finestra temporale fra scoperta, exploit e attacco continua ad accorciarsi fino a rendere inadeguata la nostra attuale organizzazione della sicurezza, mentre software che consideravamo maturi comincia a restituire una quantità di bug mai vista semplicemente perché lo stiamo osservando con strumenti infinitamente più capaci.
Se questa pressione rimane episodica, l'ecosistema si adatta. Se invece per anni la velocità di scoperta offensiva cresce più della capacità di verifica e distribuzione difensiva, allora il backlog aumenta, i maintainer diventano il collo di bottiglia, le organizzazioni più piccole restano indietro ed ogni nuova release nasce già dentro una corsa contro il tempo. È questo che chiamo breakdown strutturale: non la fine dell'informatica, ma la perdita dell'equilibrio nel quale il ciclo patch, test, distribuzione riesce ancora a stare davanti alla weaponization.
La cosa positiva è che sappiamo già quale sia la direzione da prendere perché DARPA, Google, OpenAI, Anthropic, NIST e la comunità open source stanno costruendo pezzi differenti della stessa risposta. Manca ancora un livello realmente standardizzato e generalizzato nel quale una distro o una release importante venga sottoposta prima della pubblicazione ad una offensiva AI indipendente, riproducibile e continua, ma gli ingredienti tecnici esistono quasi tutti.
Io credo che arriveremo proprio lì. Non ad un antivirus più intelligente installato dopo, ma ad un nuovo cancello prima della produzione, nel quale il software deve sopravvivere ad agenti che lo trattano come un nemico prima di ricevere una firma e venire distribuito. Il risultato non sarà software invulnerabile, perché questo traguardo non esiste, ma una drastica riduzione del vantaggio temporale dell'attaccante.
Ed è questo il punto sul quale si giocherà davvero la sicurezza informatica dell'era AI: non chi sarà capace di trovare più falle, perché entrambe le parti ne troveranno moltissime, ma se riusciremo a rendere la verifica, la correzione e soprattutto la distribuzione della correzione veloci almeno quanto la capacità automatica di trasformare una debolezza in un attacco funzionante. Se non ci riusciremo il rischio di una instabilità cronica dell'infrastruttura informatica è reale; se ci riusciremo, la stessa tecnologia che oggi ci fa vedere improvvisamente buchi rimasti nascosti per vent'anni potrebbe produrre il software più controllato che abbiamo mai costruito.

Commenti
Nessun commento, per ora.
Per commentare serve un accesso. Qui siamo tutti tecnici e colleghi!
Accedi per commentare