L'AI può aiutare enormemente nella ricerca e nella scrittura giuridica, ma non trasforma chiunque in un avvocato e soprattutto non sostituisce la verifica delle fonti. Le cosiddette legal hallucinations sono ormai documentate nei tribunali di più Paesi, dove modelli generativi hanno inventato sentenze, citazioni e principi giuridici plausibili ma inesistenti, lasciando comunque al professionista che firma l'atto la responsabilità del controllo finale.
Tutti avvocati con l'AI, almeno finché il giudice non cerca la sentenza
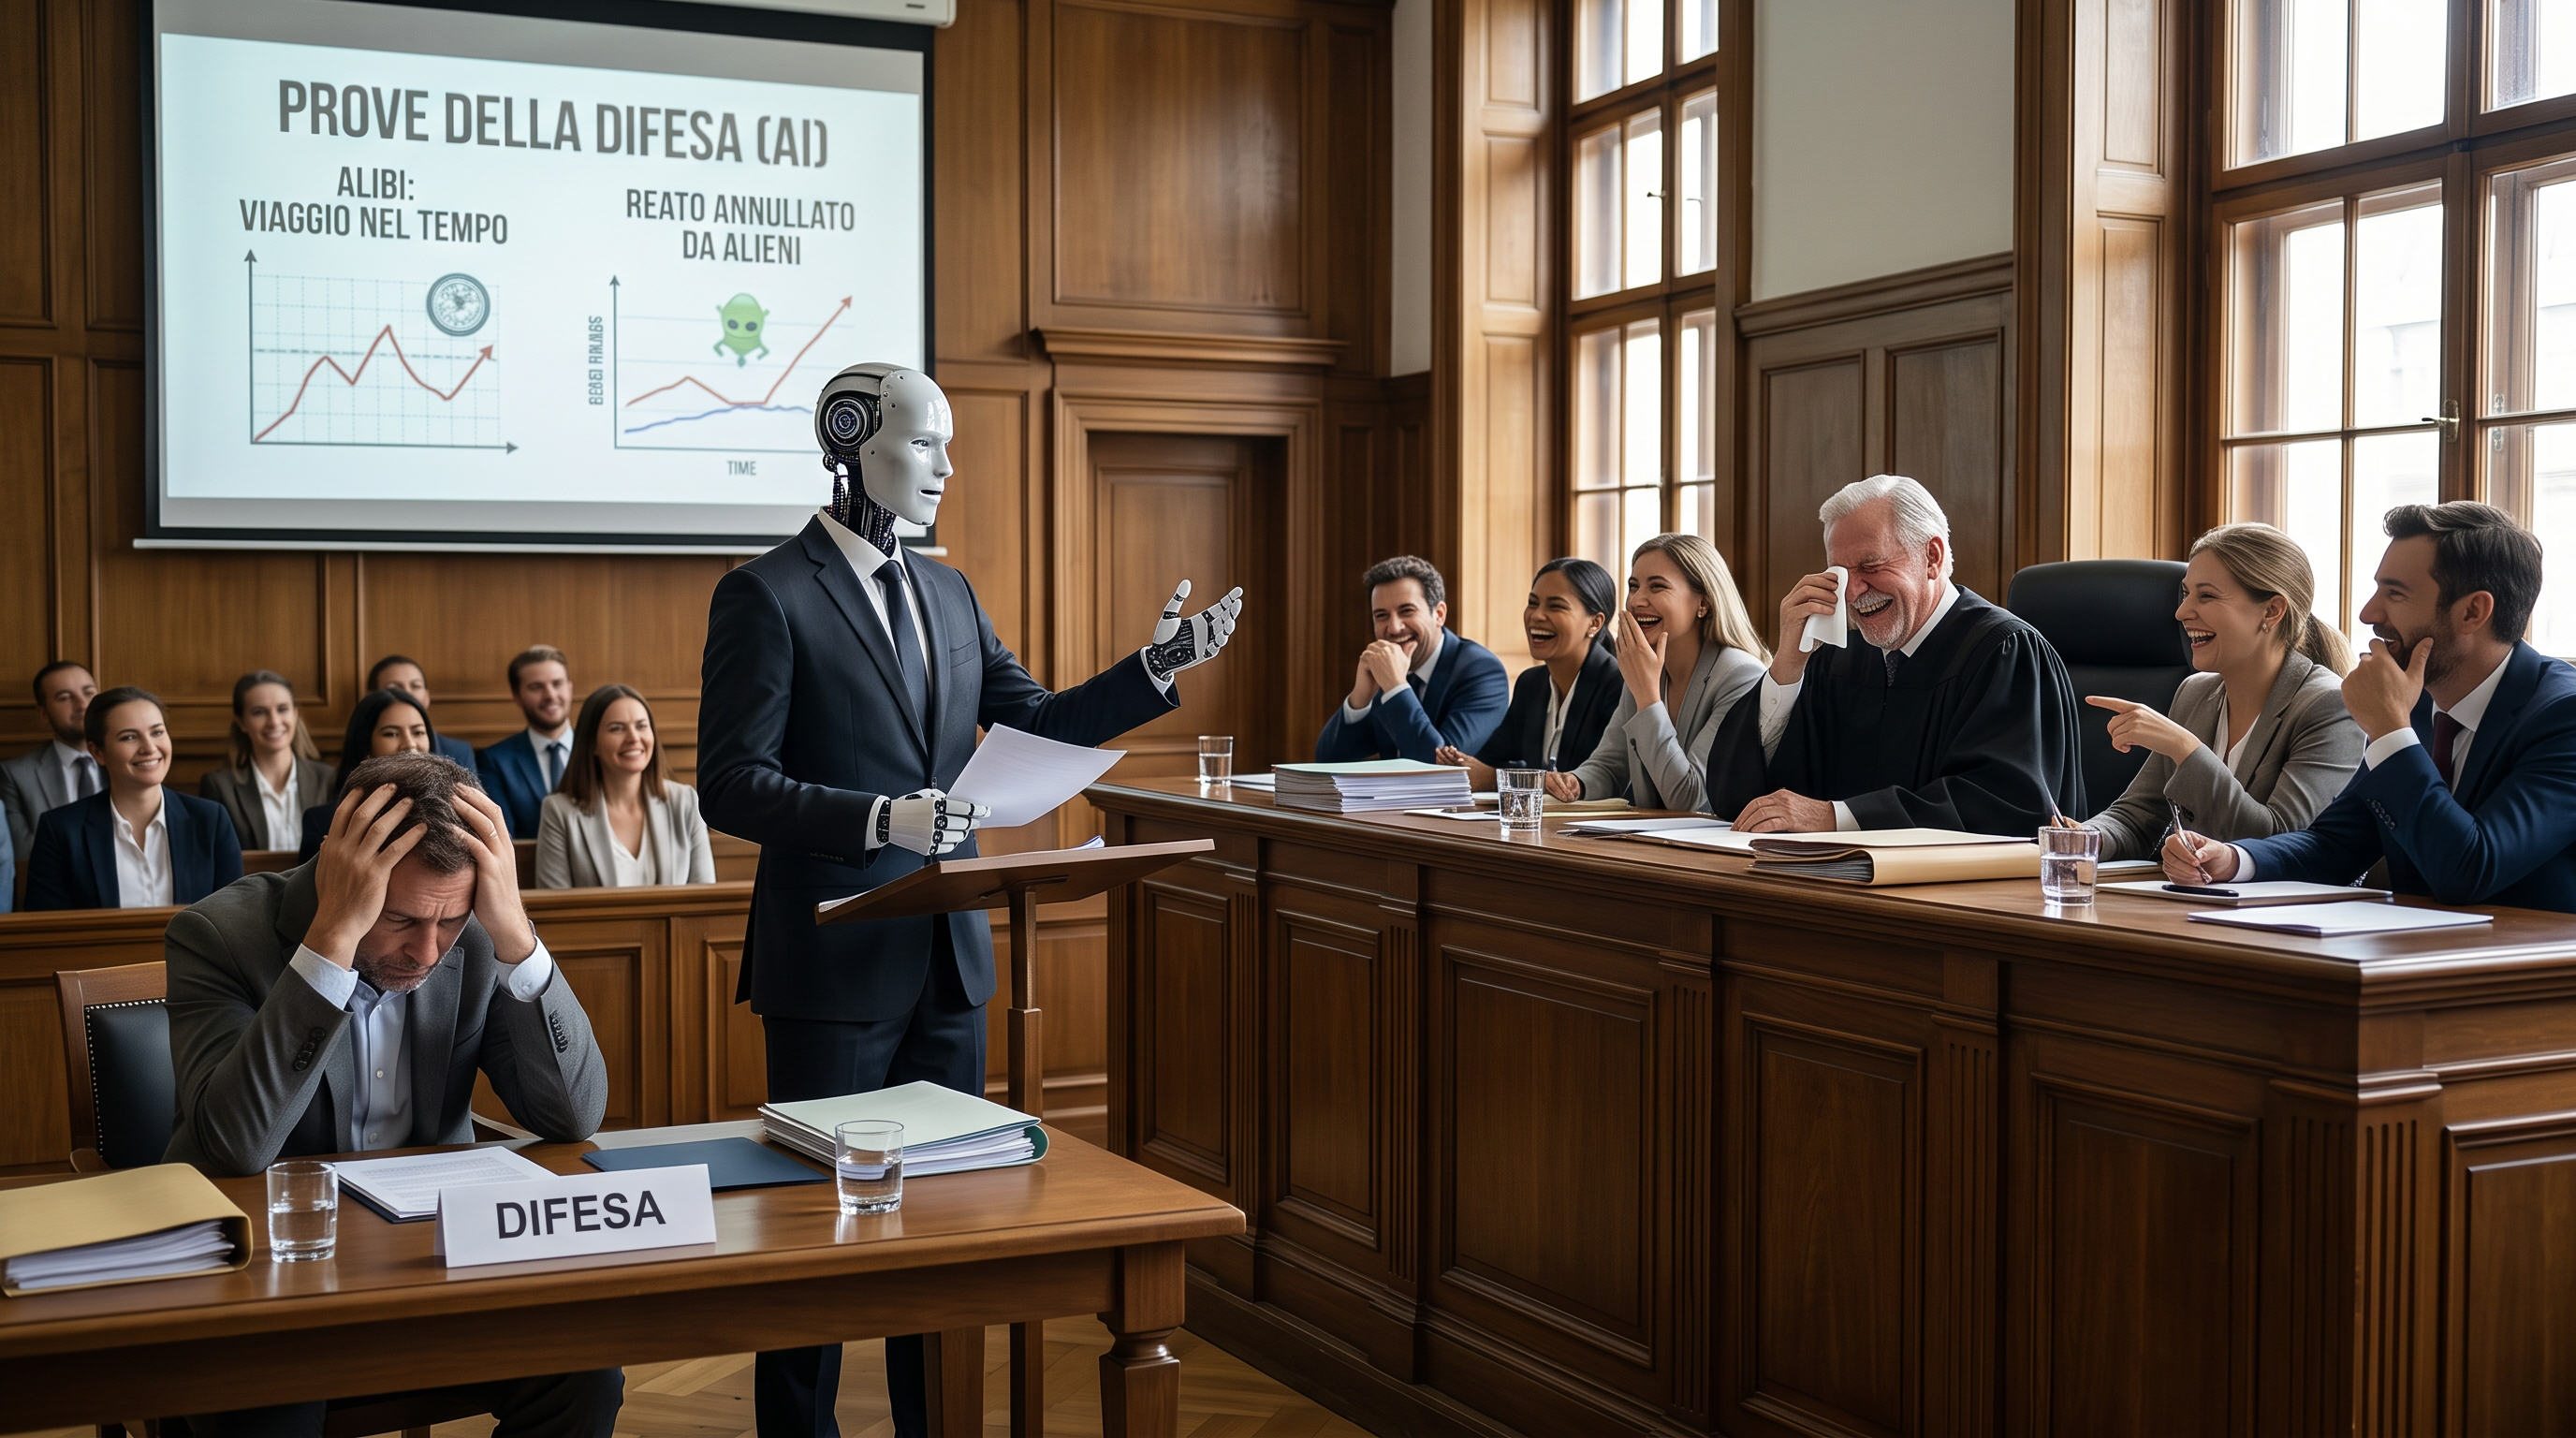
Se avete provato almeno una volta a chiedere ad un moderno modello linguistico di costruire un'argomentazione giuridica, saprete certamente quanto il risultato possa essere impressionante, perché nel giro di pochi secondi compaiono una ricostruzione ordinata dei fatti, riferimenti normativi, richiami alla giurisprudenza, formule che sembrano uscite da una memoria difensiva ed una sicurezza espositiva che, a prima vista, può far pensare di avere davanti non un software ma un professionista che conosce perfettamente la materia. Il problema comincia quando qualcuno prende quella prosa molto convincente, la copia in un atto ed arriva davanti ad un giudice che fa la cosa più banale del mondo, cioè cerca la sentenza citata e scopre che NON ESISTE, oppure scopre che la sentenza esiste ma parla d'altro, oppure ancora che il numero, l'anno ed il giudice sono corretti ma la massima riportata non compare da nessuna parte. A quel punto il miracolo dell'AI finisce molto velocemente e rimane una domanda piuttosto scomoda, chi ha verificato ciò che è stato depositato?
Questo fenomeno non è più una curiosità dei primi mesi di ChatGPT ed ha ormai un nome abbastanza preciso nella letteratura scientifica e professionale, legal hallucinations, cioè allucinazioni giuridiche, mentre nei provvedimenti dei tribunali troviamo anche espressioni come hallucinated citations, fake authorities, fictitious cases oppure semplicemente citazioni inesistenti. Non esiste una nuova categoria misteriosa di errore processuale inventata dall'AI, esiste piuttosto una vecchia responsabilità professionale che incontra una macchina capace di produrre falsità con una qualità linguistica molto superiore a quella con cui eravamo abituati a riconoscere un errore. Ed è proprio questo, a mio parere, l'aspetto più insidioso, perché una sciocchezza scritta male ci mette in allarme mentre una sciocchezza scritta PERFETTAMENTE può attraversare il nostro controllo con molta più facilità.
Mata v. Avianca, il caso che ha fatto capire a tutti quale fosse il problema
Il caso diventato simbolo di questa nuova categoria di incidenti è Mata v. Avianca, deciso nel 2023 dal giudice federale P. Kevin Castel nel Southern District of New York, nel quale gli avvocati del ricorrente depositarono un atto contenente precedenti che ChatGPT aveva semplicemente inventato. Fra le decisioni richiamate comparivano casi con nomi, citazioni, giudici ed estratti apparentemente credibili, ma il problema era che quelle decisioni non esistevano, e quando la controparte ed il tribunale non riuscirono a trovarle la vicenda divenne ancora più grave perché furono prodotte anche presunte copie ed estratti delle false pronunce. Il giudice impose sanzioni per 5.000 dollari ed ordinò, fra l'altro, che venissero inviate comunicazioni ai giudici ai quali erano state falsamente attribuite quelle decisioni.
La parte forse più importante di quel provvedimento non è però la multa, perché il giudice non disse affatto che utilizzare uno strumento di Intelligenza Artificiale fosse di per sé scorretto, disse qualcosa di molto più semplice e molto più pesante, cioè che l'avvocato mantiene un ruolo di gatekeeper e deve assicurarsi dell'accuratezza di ciò che firma e deposita. Questa impostazione è diventata negli anni successivi quasi il punto fermo internazionale, ed infatti nel giugno 2026 anche la Corte d'Appello federale del Ninth Circuit, nel caso LNU v. Blanche, ha sanzionato due avvocati per atti contenenti casi inesistenti, citazioni attribuite male e rappresentazioni grossolanamente errate di precedenti reali, precisando però che la sanzione non nasceva dal semplice utilizzo dell'AI ma dal fatto di avere firmato e depositato materiale falso senza un controllo adeguato. Il passaggio è fondamentale perché sposta il problema dal giocattolo tecnologico alla RESPONSABILITÀ DI CHI LO USA.
Anche in Italia ci siamo già arrivati
Pensare che queste siano soltanto stranezze americane sarebbe ormai piuttosto ingenuo, perché nel marzo 2025 il Tribunale di Firenze si è trovato davanti riferimenti giurisprudenziali inesistenti o dal contenuto non corrispondente a quello riportato, che secondo quanto dichiarato in giudizio provenivano da una ricerca effettuata con ChatGPT da una collaboratrice di studio. Il tribunale descrisse espressamente il fenomeno delle allucinazioni dell'Intelligenza Artificiale, cioè quei risultati inesistenti che il sistema può perfino confermare come veri quando gli vengono nuovamente sottoposti, anche se in quel caso specifico non accolse la richiesta di condanna per responsabilità aggravata.
Pochi mesi dopo il TAR Lombardia, con la sentenza n. 3348 del 21 ottobre 2025, fu molto più netto su un punto che interessa direttamente chiunque eserciti la professione, perché affermò che la sottoscrizione dell'atto attribuisce al difensore la responsabilità del contenuto indipendentemente dal fatto che quel testo sia stato materialmente scritto da lui, da un collaboratore oppure con l'aiuto di sistemi di Intelligenza Artificiale, ed il collegio richiamò proprio l'onere di verifica e controllo dei risultati prodotti da questi strumenti. La vicenda riguardava un ricorso nel quale erano stati citati precedenti non pertinenti oppure inesistenti, ed il tribunale trasmise la sentenza al Consiglio dell'Ordine degli Avvocati per le valutazioni di competenza. In pratica la formula "me l'ha detto l'AI" non è una difesa, esattamente come non lo sarebbe dire "me l'ha scritto il praticante".
Dal 10 ottobre 2025 in Italia esiste inoltre una cornice legislativa molto chiara per le professioni intellettuali, perché l'articolo 13 della legge n. 132 del 23 settembre 2025 stabilisce che l'utilizzo dei sistemi di Intelligenza Artificiale deve restare strumentale e di supporto all'attività professionale, con prevalenza del lavoro intellettuale oggetto della prestazione, ed impone anche di comunicare al destinatario della prestazione le informazioni relative ai sistemi di AI utilizzati in modo chiaro, semplice ed esaustivo. Questo non significa che ogni testo prodotto con un assistente debba diventare una confessione tecnica lunga tre pagine, significa però che il legislatore italiano ha fissato un principio che va nella stessa direzione dei tribunali, cioè L'AI ASSISTE IL PROFESSIONISTA, NON PRENDE IL SUO POSTO.
Nel Regno Unito i giudici hanno scritto nero su bianco che il modello non è una banca dati giuridica
Nel 2025 la High Court inglese ha riunito due vicende, Ayinde v. London Borough of Haringey ed Al-Haroun v. Qatar National Bank, proprio per affrontare l'uso di materiale giuridico falso o sospetto generato mediante sistemi di AI, ed il giudizio contiene una considerazione che sarebbe utile tenere accanto a qualunque casella di prompt utilizzata per fare ricerca legale, perché ricorda che gli strumenti generativi liberamente disponibili non sono in grado di svolgere ricerca giuridica affidabile nel senso professionale del termine. Possono produrre risposte coerenti e plausibili che però sono completamente sbagliate, possono citare fonti inesistenti ed attribuire ad una fonte reale parole che quella fonte non contiene.
Nel caso Al-Haroun il materiale sottoposto al tribunale comprendeva quarantacinque citazioni, diciotto delle quali si riferivano a casi che non esistevano, mentre molte delle restanti decisioni reali non contenevano le frasi attribuite loro oppure non sostenevano affatto la tesi per la quale erano state invocate. Questo ci porta ad una distinzione che reputo ancora più importante del classico caso inventato, perché l'allucinazione giuridica non è soltanto "Corte di Cassazione n. 12345 che non esiste", può essere anche una sentenza vera utilizzata per sostenere un principio che quella sentenza NON HA MAI AFFERMATO. Ed è precisamente la seconda categoria ad essere più pericolosa per chi controlla in fretta, visto che digitando il numero trova realmente un provvedimento ed è portato a considerare risolto il problema senza leggerne il testo.
Perché un LLM inventa una sentenza con tanta sicurezza
Per capire il problema bisogna smettere per un momento di pensare ad un LLM come ad un motore di ricerca. Un modello linguistico genera testo calcolando, passo dopo passo, quali token siano più plausibili nel contesto che ha ricevuto, quindi quando gli chiediamo "indicami tre sentenze della Cassazione che stabiliscono questo principio" non entra necessariamente in un archivio ufficiale, non apre tre PDF, non legge il dispositivo e non verifica che i numeri esistano, a meno che il sistema nel quale il modello è inserito disponga realmente di questi strumenti e sia stato progettato per usarli. Il modello puro conosce invece una quantità enorme di regolarità linguistiche, sa perfettamente quale forma abbia una citazione della Cassazione, come venga costruita una massima, quali parole suonino naturali dopo "secondo consolidato orientamento" ed in quale stile normalmente si scriva una motivazione giuridica.
Se nel proprio stato statistico trova abbastanza elementi per costruire una risposta plausibile ma non abbastanza informazione per recuperare il fatto preciso, può completare la struttura con qualcosa che linguisticamente funziona benissimo ma fattualmente non esiste. In altre parole non sta necessariamente "mentendo", perché mentire presupporrebbe conoscere la verità e decidere di nasconderla, sta ottimizzando la generazione del testo secondo il meccanismo per il quale è stato costruito. Ed il diritto è un terreno particolarmente difficile perché una piccola differenza di data, giurisdizione, sezione, grado di giudizio oppure formulazione può trasformare una fonte apparentemente pertinente in una fonte completamente inutile.
C'è poi un secondo meccanismo, quello che nei lavori di ricerca viene spesso collegato alla sycophancy, cioè alla tendenza del modello ad assecondare la premessa dell'utente. Se io chiedo "qual è la sentenza che ha stabilito che il termine è sempre perentorio?" sto già suggerendo che una simile sentenza debba esistere, ed un modello poco robusto può tentare di soddisfare la forma della richiesta invece di fermarsi e rispondere che la premessa potrebbe essere falsa. Nel diritto questa caratteristica è devastante, perché il professionista tende naturalmente a cercare precedenti favorevoli alla propria tesi ed il modello rischia di diventare non un ricercatore ma un collaboratore troppo compiacente, che trova sempre esattamente ciò che gli abbiamo chiesto anche quando non c'è.
Gli studi seri esistono ed i numeri non sono affatto rassicuranti
Nel 2024 un gruppo di ricercatori di Stanford e Yale pubblicò Large Legal Fictions, uno dei primi studi sistematici sulle legal hallucinations, sottoponendo ai modelli domande verificabili relative a casi federali statunitensi. In quelle condizioni sperimentali le allucinazioni comparivano con frequenze molto elevate, arrivando almeno al 58 per cento con GPT-4 nelle prove considerate e salendo ulteriormente con altri modelli dell'epoca, ma il risultato che considero più istruttivo non è neppure la percentuale grezza, è il fatto che i modelli mostravano difficoltà anche nel riconoscere i propri errori ed accettavano spesso premesse giuridiche false introdotte dall'utente.
Qualcuno potrebbe obiettare che quei test riguardavano chatbot generalisti e che gli strumenti professionali moderni usano banche dati giuridiche vere, ed è corretto, infatti il passo successivo dei ricercatori è stato proprio verificare sistemi RAG (Retrieval-Augmented Generation) commerciali destinati alla ricerca legale. Il risultato pubblicato nel Journal of Empirical Legal Studies nel 2025 è più confortante ma non abbastanza da permetterci di spegnere il cervello, perché i prodotti di LexisNexis e Thomson Reuters analizzati nello studio riducevano sensibilmente il problema rispetto ai chatbot generalisti ma continuavano comunque a generare informazioni false o fuorvianti in una quota significativa delle interrogazioni, con tassi superiori al 17 per cento per alcuni sistemi ed oltre il 30 per cento per un altro nelle condizioni del benchmark.
Questi numeri NON vanno interpretati come la probabilità universale che una qualunque domanda giuridica posta oggi ad un qualunque sistema produca una risposta falsa, perché dipendono dai modelli, dal dataset, dalla difficoltà delle domande e dall'anno nel quale il test viene eseguito, ma dimostrano una cosa molto più importante, il problema non scompare semplicemente perché abbiamo collegato il modello ad una banca dati.
Il RAG aiuta moltissimo, ma non è l'acqua santa contro le allucinazioni
RAG significa Retrieval-Augmented Generation ed il concetto è intelligente, perché prima di chiedere al modello di formulare la risposta un motore di retrieval cerca documenti che dovrebbero essere pertinenti e li inserisce nel contesto, in modo che il modello possa rispondere usando fonti reali invece di affidarsi soltanto a ciò che ha appreso durante l'addestramento. In un sistema giuridico ben costruito questa architettura cambia completamente il livello di affidabilità, perché il modello può ricevere il testo effettivo della legge, della sentenza oppure del regolamento e costruire la spiegazione su quel materiale.
Ma il RAG sposta una parte del problema invece di eliminarla, perché prima bisogna trovare IL DOCUMENTO GIUSTO. Una ricerca semantica può recuperare una sentenza che parla delle stesse parole ma appartiene ad un'altra giurisdizione, può trovare un orientamento superato, può perdere un'eccezione contenuta in un comma lontano, può privilegiare una decisione molto simile lessicalmente ma non vincolante ed il generatore può comunque interpretare male il passaggio recuperato. Gli studiosi di Stanford hanno chiamato misgrounding proprio uno dei casi più insidiosi, nel quale l'affermazione può perfino sembrare giuridicamente ragionevole ma la fonte citata NON SUPPORTA realmente quella proposizione.
Per questo un sistema serio non dovrebbe limitarsi a fare retrieval ed incollare tre riferimenti sotto una risposta, dovrebbe verificare che la fonte esista, che appartenga alla giurisdizione richiesta, che sia temporalmente applicabile, che il passaggio citato compaia realmente nel documento, che quel documento abbia il peso giuridico attribuitogli e che non esista una fonte successiva che lo abbia superato. Questa non è più semplice prompt engineering, è INGEGNERIA DEL SISTEMA.
Un prompt brillante non basta, serve un agente che sappia anche fermarsi
Arriviamo così al punto che trovo tecnicamente più interessante, perché continuiamo a parlare di come scrivere il prompt perfetto quando il vero salto qualitativo consiste nel costruire un sistema che non abbia soltanto il diritto di parlare ma anche il dovere di NON RISPONDERE quando non possiede prove sufficienti. Se chiedo ad un agente giuridico di trovare la giurisprudenza applicabile ad un caso, il comportamento corretto non dovrebbe essere generare immediatamente tre precedenti, dovrebbe prima decomporre la domanda, determinare la giurisdizione, capire l'intervallo temporale rilevante, interrogare fonti autorevoli, recuperare i testi integrali, controllare i metadati, confrontare il principio che vuole esporre con i passaggi effettivamente presenti ed infine costruire una risposta nella quale ogni affermazione importante sia collegabile ad una fonte verificabile.
Se non trova abbastanza materiale, l'agente deve poter arrivare ad una conclusione che molti chatbot generalisti sono stati storicamente poco incentivati a pronunciare, cioè "non dispongo di una fonte affidabile per sostenere questa affermazione". Questo comportamento viene spesso chiamato abstention, ed in un sistema ad alto rischio è una funzione tanto importante quanto la capacità di rispondere, perché un modello che sa fermarsi davanti ad un vuoto informativo è molto più utile di un modello che mantiene una conversazione perfetta riempiendo quel vuoto con una sentenza inventata.
Ed è qui che il discorso diventa davvero agentico, perché un sistema ben progettato può reagire al vuoto informativo usando strumenti diversi, cercare in una seconda banca dati, restringere oppure ampliare la query, controllare il testo normativo vigente, verificare una citazione attraverso un resolver indipendente, confrontare l'output con un secondo passaggio di validazione ed infine segnalare all'operatore umano ciò che non è stato risolto. In questo schema l'LLM non è la fonte del diritto, è il motore linguistico e di ragionamento che coordina strumenti ESTERNI ai quali spetta il compito di fornire evidenza.
La vera architettura sicura ha due percorsi separati, generazione e verifica
Io progetterei un sistema giuridico serio evitando che lo stesso passaggio che costruisce una tesi abbia anche l'ultima parola sulla sua correttezza, perché esiste un evidente conflitto logico nel chiedere al generatore "sei sicuro di ciò che hai appena scritto?" ed aspettarsi che questa seconda domanda trasformi automaticamente una fonte falsa in una fonte vera. Se il modello ha costruito una citazione plausibile, può perfino confermarla con maggiore convinzione, come è successo proprio in alcuni dei casi finiti davanti ai tribunali.
Serve invece una verifica indipendente, nella quale la stringa della citazione viene risolta contro una banca dati autorevole, il documento viene recuperato realmente, l'identificativo viene confrontato con giudice, data e parti, il passaggio citato viene cercato nel testo e la proposizione generata viene sottoposta ad una verifica di entailment, cioè si controlla se il contenuto della fonte implica davvero ciò che il modello sostiene. Per la normativa bisogna inoltre verificare la versione vigente alla data rilevante, perché citare correttamente un articolo che però era stato modificato prima dei fatti è un errore meno spettacolare della sentenza inventata ma processualmente può essere molto più dannoso.
Questo controllo può essere ulteriormente irrigidito impedendo tecnicamente al modello di creare una citazione libera, facendogli invece scegliere soltanto identificativi restituiti dal motore di ricerca, in modo che numero, anno, corte e riferimento documentale provengano da un record strutturato e non dalla generazione probabilistica. Anche così rimane il rischio che il modello interpreti male la fonte, ma almeno eliminiamo una categoria intera di errore, quella nella quale la citazione nasce dal nulla.
Una delle ingenuità più comuni consiste nel dire all'AI "cerca su Internet" e considerare risolto il problema dell'aggiornamento, quando invece un motore giuridico serio deve sapere che non tutte le fonti hanno lo stesso valore. Una sentenza pubblicata nella banca dati ufficiale del giudice, un testo normativo consolidato, una Gazzetta Ufficiale, una massima redazionale, un articolo di studio legale ed un post su un forum possono parlare dello stesso argomento ma NON SONO INTERCAMBIABILI.
L'agente dovrebbe quindi lavorare con una gerarchia esplicita delle fonti, privilegiando testi normativi e provvedimenti ufficiali, poi repertori professionali verificati ed infine materiale secondario per orientare la ricerca, e dovrebbe conservare per ogni documento almeno origine, data di acquisizione, giurisdizione, identificativo, versione ed eventualmente un hash che permetta di dimostrare quale testo sia stato effettivamente utilizzato. Quando la materia dipende da una data, come accade continuamente nel diritto, il sistema deve inoltre poter rispondere non soltanto alla domanda "qual è la norma" ma "quale norma ERA vigente il giorno in cui è avvenuto il fatto".
A questo punto il lettore capirà probabilmente perché ritengo insufficiente dire che basta essere un bravo avvocato e scrivere un prompt migliore. Per usare bene un assistente già costruito non serve certamente diventare ingegneri dell'AI, ma per PROGETTARE un sistema autonomo che faccia ricerca, controlli fonti, decida quando fermarsi ed aggiorni il proprio contesto servono competenze di retrieval, orchestrazione agentica, sicurezza, gestione dei dati, evaluation, versioning, osservabilità ed audit, insieme naturalmente ad una competenza giuridica profonda che definisca cosa significhi davvero una risposta corretta. Un ingegnere senza giurista costruirebbe facilmente una macchina velocissima che non capisce la gerarchia delle fonti, mentre un giurista senza ingegneria rischierebbe di costruire una lunga istruzione testuale sperando che il modello obbedisca sempre.
Dire che la responsabilità è "sempre e solo umana" rende bene il principio professionale secondo il quale chi firma un atto non può scaricare sul modello il proprio dovere di controllo, ma preso alla lettera sarebbe troppo assoluto, perché possono esistere anche responsabilità del produttore del software, del fornitore, dell'organizzazione oppure altri profili giuridici che dipendono dal caso concreto e dalla normativa applicabile. Quello che i tribunali stanno però dicendo con crescente chiarezza è che L'USO DELL'AI NON CANCELLA LA RESPONSABILITÀ DEL PROFESSIONISTA.
L'ABA (American Bar Association), nella Formal Opinion 512 del 2024, ha ricondotto l'uso dell'AI generativa ai normali obblighi di competenza, riservatezza, comunicazione, supervisione, correttezza verso il tribunale e ragionevolezza dei compensi, mentre le linee guida della magistratura di Inghilterra e Galles ribadiscono la responsabilità personale di chi produce materiale nel proprio nome. Anche la legge italiana del 2025 va nella stessa direzione antropocentrica, perché considera l'AI uno strumento di supporto e mantiene la prevalenza del lavoro intellettuale professionale. La tecnologia cambia, ma la firma in fondo all'atto continua ad avere un significato.
Il problema non è soltanto l'avvocato inesperto, può cascarci anche chi conosce molto bene il diritto
Sarebbe rassicurante pensare che le allucinazioni giuridiche colpiscano soltanto chi non sa nulla di diritto ed usa un chatbot per fingersi avvocato, ma sarebbe una lettura troppo comoda, perché proprio la qualità linguistica dei modelli può ingannare anche professionisti esperti quando il riferimento cade in un settore laterale, quando il carico di lavoro è elevato oppure quando la risposta conferma esattamente ciò che ci aspettavamo di trovare. Il bias di conferma qui lavora benissimo insieme alla sycophancy del modello, io cerco una sentenza favorevole, il sistema me la offre, la massima è perfettamente coerente con la mia tesi e quindi ho meno incentivo psicologico a metterla in dubbio.
È anche per questo che gli studi sui sistemi giuridici specializzati sono così importanti, perché dimostrano che collegare l'LLM a fonti professionali riduce gli errori ma non elimina la necessità del controllo. Nel diritto la verifica non consiste soltanto nell'accertare che il documento esista, bisogna leggerlo, capire la ratio, verificare se il passaggio sia obiter oppure decisivo, controllare il grado del giudizio, vedere se l'orientamento sia stato superato ed accertare che il principio possa davvero essere trasferito al caso concreto. Queste operazioni sono precisamente il motivo per cui sapere leggere diritto rimane diverso dal saper generare una prosa che SUONA giuridica.
E per il cittadino che vuole fare da solo il rischio è ancora maggiore
L'AI ha un potenziale enorme nel rendere il diritto più accessibile, perché può spiegare un provvedimento, tradurre un linguaggio tecnico, aiutare a preparare domande per un professionista, riordinare documenti ed indicare quali questioni meritino approfondimento, ma proprio chi non possiede una formazione giuridica ha meno strumenti per riconoscere quando la risposta sta deragliando. Se un cittadino riceve una falsa sentenza con numero, anno, sezione e massima, la forma stessa della risposta gli comunica autorevolezza e potrebbe indurlo a prendere decisioni reali su termini, ricorsi, denaro, rapporti di lavoro oppure questioni familiari.
Lo studio Large Legal Fictions sottolineava infatti che i rischi possono essere particolarmente alti proprio per chi avrebbe più da guadagnare dall'accesso economico all'AI, cioè persone senza assistenza legale tradizionale. Questo non significa che un cittadino non debba utilizzare questi strumenti, significa che deve sapere DOVE finisce l'aiuto informativo e dove comincia una decisione che richiede verifica professionale e fonti primarie. L'AI può abbassare enormemente il costo di comprendere il problema, non deve abbassare contemporaneamente la soglia con cui decidiamo che una fonte è vera.
La soluzione non è vietare l'AI agli avvocati, è costruirla meglio ed usarla con un metodo diverso
Sarebbe paradossale reagire a tutto questo vietando l'Intelligenza Artificiale nel lavoro legale, perché gli stessi strumenti che possono inventare una citazione sono capaci di confrontare centinaia di documenti, individuare clausole incoerenti, sintetizzare fascicoli enormi, costruire timeline, estrarre entità, ricercare passaggi semanticamente simili ed assistere nella redazione con una velocità che nessun professionista può ignorare. La questione non è quindi AI sì oppure AI no, ma quale architettura, quali fonti, quali permessi, quali controlli e quale livello di autonomia.
Io vedo il sistema giuridico più affidabile non come un singolo chatbot ma come una piccola squadra di componenti, nella quale un agente interpreta la richiesta, un motore di retrieval consulta soltanto corpus autorizzati, un verificatore controlla le citazioni, un altro passaggio confronta la risposta con il testo delle fonti ed una regola finale impedisce di presentare come certo ciò che non supera una soglia stabilita. Tutto deve lasciare una traccia, così che a distanza di settimane si possa ricostruire quale versione del modello è stata usata, quali documenti sono stati recuperati, quali query sono state eseguite e perché una determinata fonte è entrata nella risposta. In un'aula di tribunale l'auditabilità non è un lusso tecnico, è parte della fiducia.
L'AI non ci rende tutti avvocati, ci rende tutti molto più capaci di sembrare avvocati
Ed è forse questa la conclusione che trovo più interessante, perché prima dell'AI una persona priva di competenze giuridiche poteva certamente scrivere una sciocchezza, ma spesso la forma tradiva immediatamente la mancanza di preparazione, mentre oggi un LLM può trasformare un'idea sbagliata in un testo formalmente impeccabile, con terminologia, struttura, richiami e tono perfettamente compatibili con ciò che ci aspettiamo da un atto professionale. La distanza fra SAPERE e SEMBRARE DI SAPERE si è quindi ridotta in maniera impressionante, ed il diritto è uno dei settori nei quali questa differenza può costare di più.
Per questo non mi preoccupa particolarmente il fatto che l'AI sappia scrivere come un avvocato, mi preoccupa molto di più quando un sistema viene progettato senza strumenti reali di ricerca, senza una politica di astensione, senza verifica indipendente delle fonti e senza qualcuno che sappia controllare il risultato. Il futuro interessante non è il chatbot che risponde sempre, è l'agente che sa quando non possiede abbastanza informazione, interrompe la generazione, apre le fonti corrette, verifica ciò che ha trovato e soltanto dopo torna dall'essere umano. A quel punto l'AI non avrà sostituito l'avvocato ma avrà finalmente imparato a comportarsi come uno strumento degno di entrare nel suo lavoro.

Commenti
Nessun commento, per ora.
Per commentare serve un accesso. Qui siamo tutti tecnici e colleghi!
Accedi per commentare