Oggi una AI può partire da poche parole, da un'immagine, da un riff, da un MIDI oppure perfino da una voce intonata male e costruire una canzone completa con arrangiamento, cantante, testo, struttura e produzione. Il miracolo però non è magia: sotto ci sono probabilità condizionate, trasformate tempo-frequenza, codec neurali, spazi latenti, Transformer e diffusion model che hanno imparato la statistica del linguaggio musicale da enormi quantità di audio.
La cosa incredibile non è che scriva una melodia, è che ormai produce un disco
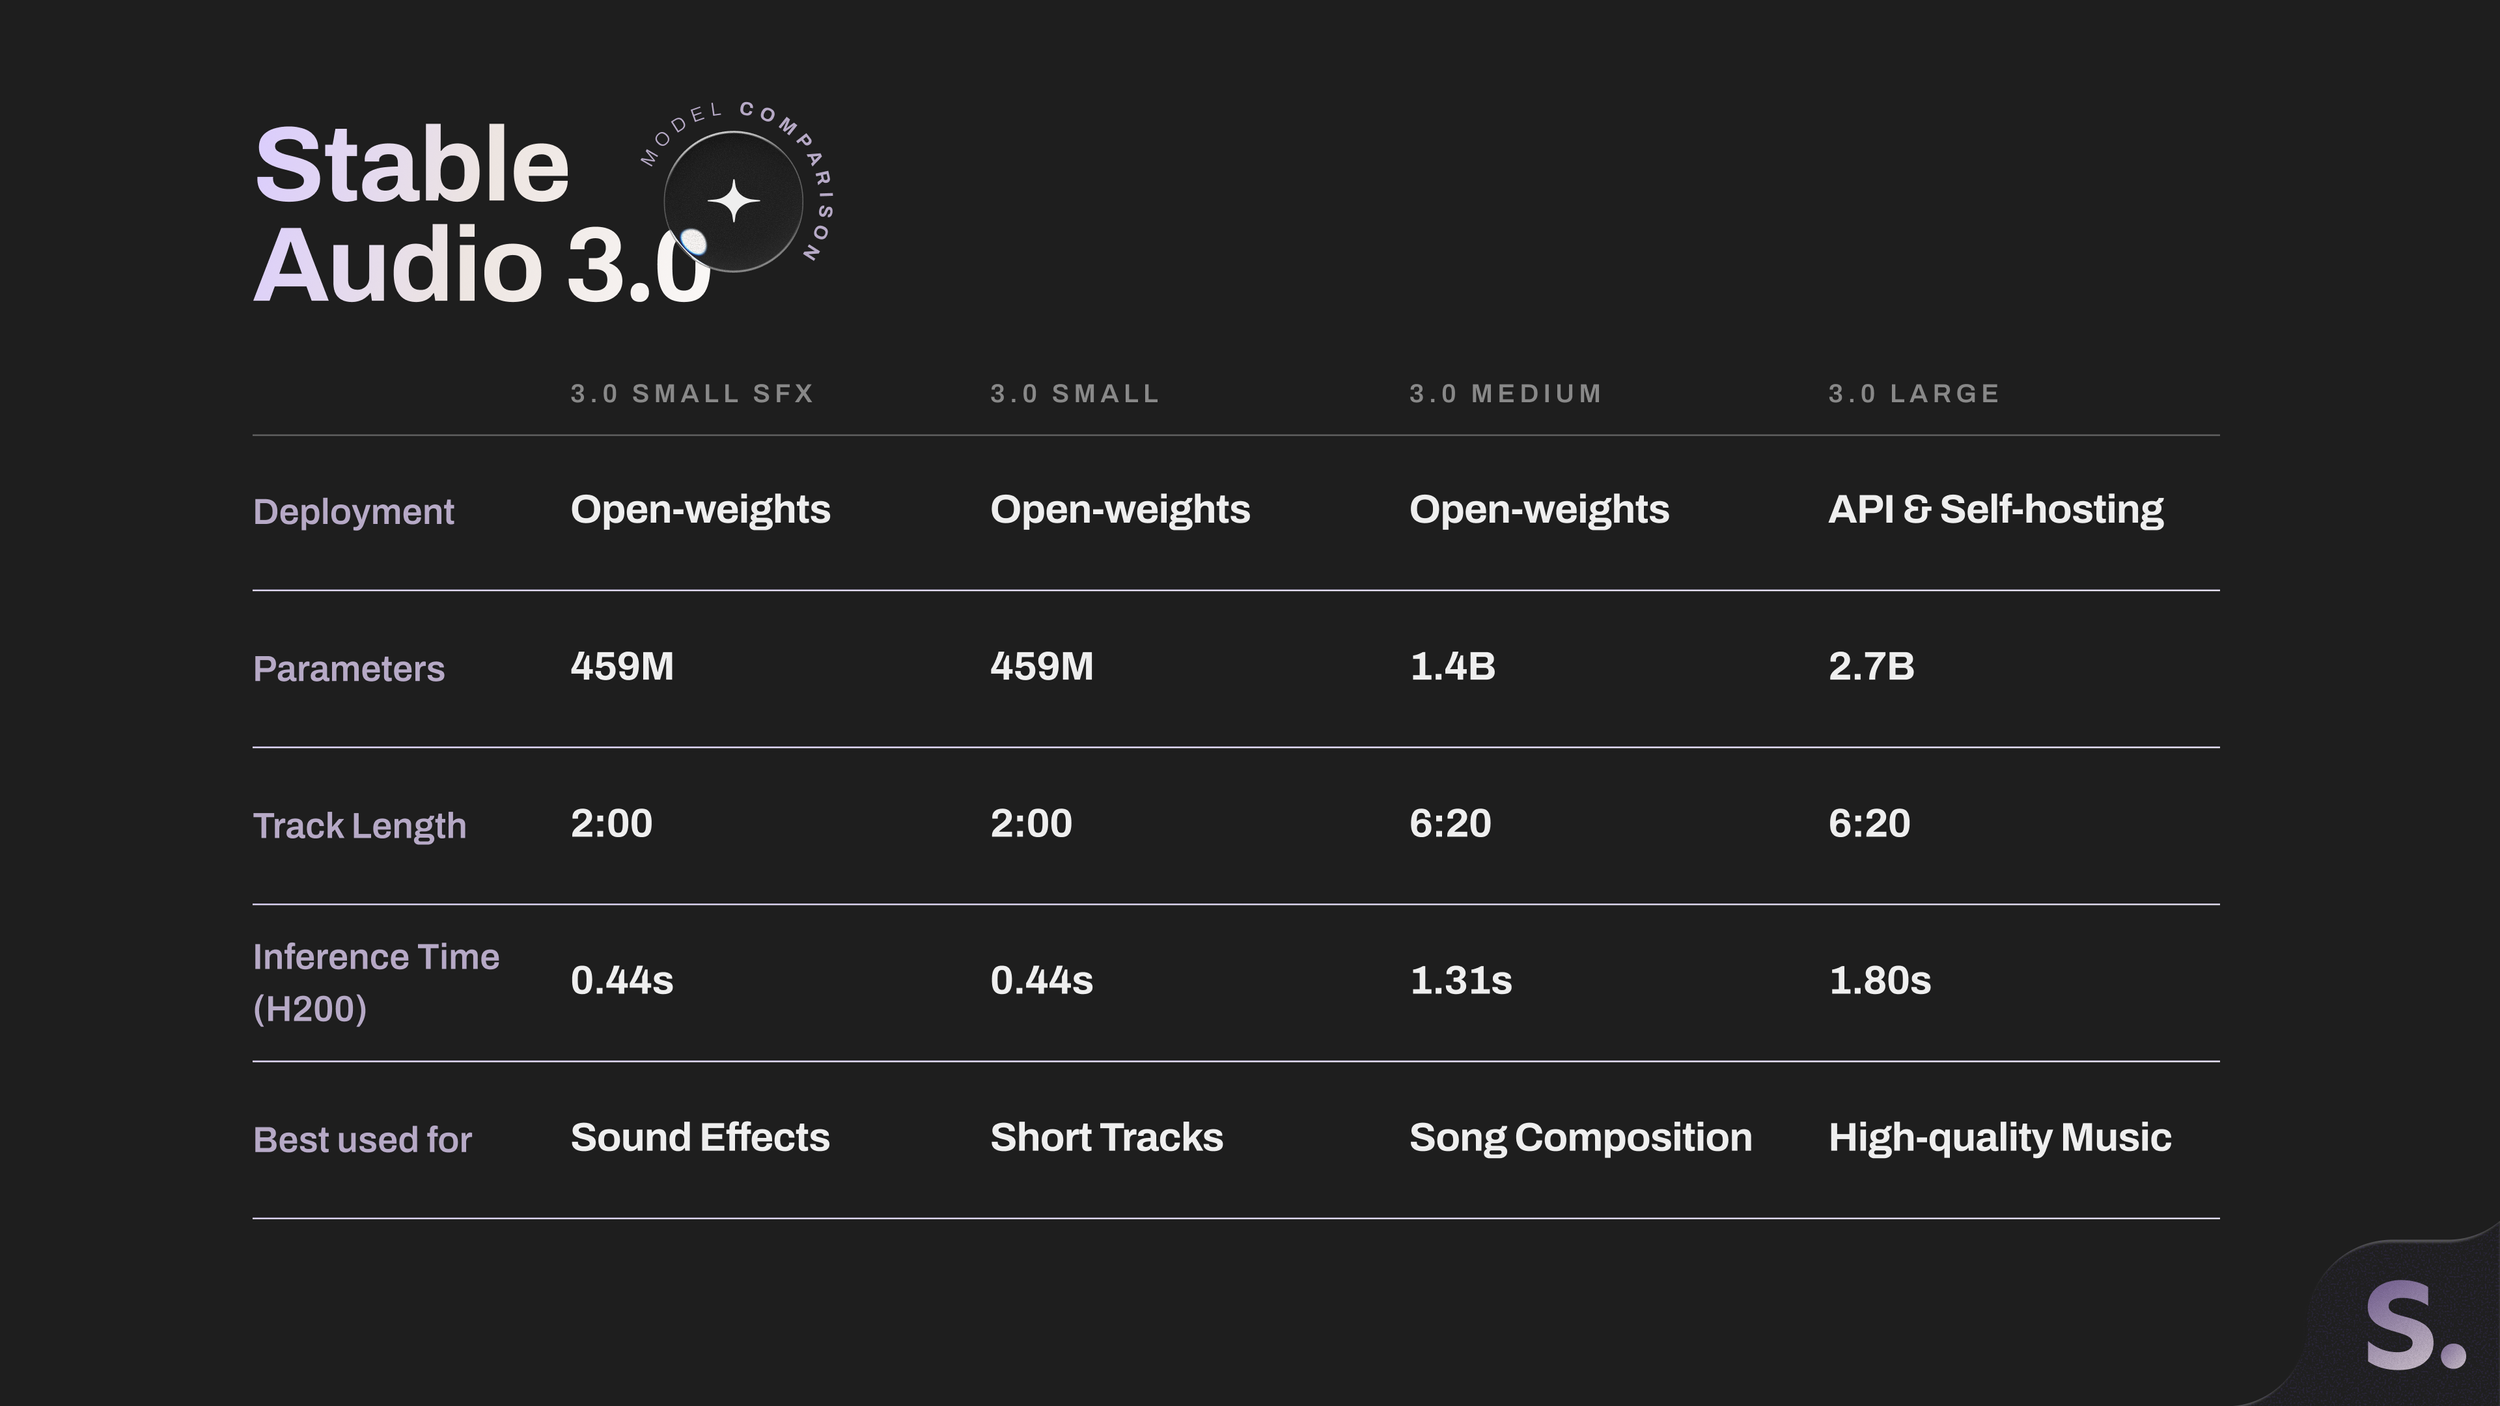
Se avete provato uno dei generatori musicali arrivati nel 2026 saprete certamente che la prima reazione è abbastanza difficile da evitare: scrivete poche righe, magari specificate un genere, una voce femminile, 96 BPM, un basso rotondo, una strofa quasi sussurrata ed un ritornello enorme, aspettate qualche secondo e dall'altra parte esce una canzone che ha batteria, basso, armonia, riverberi, dinamica, testo cantato ed una voce che respira, accentua le sillabe e sembra persino sapere dove debba entrare. Fino a pochi anni fa la generazione automatica di musica produceva soprattutto curiosità, loop credibili, piccoli frammenti oppure composizioni simboliche in MIDI, mentre adesso Suno v6 arriva fino ad otto minuti per generazione, Lyria 3.5 di Google costruisce tracce coerenti fino a tre minuti, Stable Audio 3.0 supera i sei minuti nelle versioni Medium e Large ed i sistemi non si limitano più a partire dal testo, perché possono ricevere audio, immagini, MIDI, riferimenti stilistici e pezzi già esistenti da continuare oppure modificare.
La cosa che trovo più interessante però non è la qualità del singolo brano, perché fra un anno sarà certamente migliore. È il fatto che la AI musicale sta cambiando natura: non è più soltanto una macchina alla quale chiedo "fammi una canzone rock", sta diventando una specie di STUDIO DI PRODUZIONE STATISTICO nel quale posso portare un'idea incompleta, un giro di accordi, una voce registrata male sul telefono, una parte MIDI oppure un pezzo che non mi convince e chiedere di costruire, sostituire, isolare, arrangiare, estendere ed infine rifinire soltanto ciò che voglio cambiare.
Suno v6, uscito il 9 settembre 2026, permette espressamente di partire da un canticchio, da un riff oppure da una strofa cantata e costruirci intorno una composizione, può combinare più sorgenti, isolare elementi, cambiare soltanto una sezione e perfino usare insieme testo, audio, immagini e video. Stable Audio 3.0 lavora con text-to-audio, audio-to-audio, inpainting e continuation, mentre Udio da tempo permette di estendere, remixare, modificare e stilizzare audio caricato. Siamo cioè passati dal generatore di canzoni al GENERATORE DI TRASFORMAZIONI MUSICALI.
Ma che cosa vede una AI quando sente una canzone
Qui bisogna dimenticare per un momento spartiti, note e pentagramma, perché molti dei modelli moderni non ricevono affatto una canzone nella forma simbolica con cui la leggerebbe un musicista. Ricevono audio, cioè una sequenza di numeri che rappresenta la pressione sonora campionata nel tempo. Un secondo stereo a 44.100 campioni al secondo contiene 88.200 valori prima ancora di parlare di compressione, quindi una canzone di quattro minuti contiene milioni di campioni ed addestrare un modello trattando ognuno di quei punti come fosse un token di testo sarebbe un modo magnifico per sprecare calcolo.
Per questo l'audio viene normalmente trasformato in una rappresentazione molto più compatta. Un metodo classico è guardarlo nel dominio tempo-frequenza attraverso la STFT (Short-Time Fourier Transform), che prende piccole finestre del segnale e le scompone nelle frequenze che le compongono. La formula, scritta senza farci troppo male, assomiglia a X(t,f) = Σ x[n]w[n-tH]e^(-j2πfn/N): x[n] è il nostro suono, w è una finestra che ne prende un piccolo pezzo, H stabilisce di quanto ci spostiamo nel tempo ed il termine esponenziale misura quanta energia di una certa frequenza esista in quel pezzetto.
Quello che otteniamo è uno spettrogramma, ossia una specie di fotografia nella quale un asse rappresenta il tempo, uno la frequenza ed il colore o l'intensità indicano quanta energia c'è in quella zona. Una nota di pianoforte non diventa quindi soltanto "DO", ma una fondamentale, una costellazione di armoniche, un attacco, un decadimento ed una quantità di dettagli che distinguono quello stesso DO suonato da un pianoforte, da una chitarra oppure da una voce.
I sistemi moderni possono però andare ancora oltre ed imparare da soli una rappresentazione compressa dell'audio. EnCodec di Meta, usato alla base di MusicGen, prende la forma d'onda, la comprime attraverso un encoder neurale e la trasforma in flussi di token discreti, un po' come se inventasse un proprio vocabolario acustico. MusicGen non deve quindi prevedere 44.100 campioni ogni secondo, deve prevedere successioni molto più corte di simboli che il decoder saprà poi ritrasformare in audio. Stable Audio e Lyria seguono invece la famiglia della latent diffusion, comprimendo il suono in uno spazio latente continuo molto più piccolo e facendo avvenire lì la generazione.
La musica diventa una probabilità condizionata gigantesca
Una volta compresso il suono arriva la parte che assomiglia molto di più agli LLM. Immaginiamo che il codec abbia trasformato la musica in una sequenza di token z1, z2, z3 e così via, il modello autoregressivo impara una distribuzione del tipo P(z1...zT | c) = ∏ P(zt | z1...z(t-1), c), dove c rappresenta il condizionamento, cioè il nostro prompt, una melodia, il testo da cantare oppure altre informazioni. In parole molto meno matematiche, ad ogni passo il modello chiede: dato tutto ciò che è già successo e dato ciò che l'utente mi ha chiesto, QUALE PEZZO DI MUSICA È STATISTICAMENTE PLAUSIBILE CHE VENGA ADESSO?
La risposta non è una regola scritta a mano. Dentro i pesi sono finite regolarità sulle progressioni armoniche, su quanto dura normalmente una frase, su come un fill di batteria tende ad anticipare un ritornello, su quali note una voce sceglie sopra un certo accordo, su come cambiano timbro ed intensità quando cresce la tensione, su come una cassa techno si comporta a 130 BPM oppure su dove un cantante tende a respirare dentro una frase. Nessuno ha dovuto codificare milioni di if del tipo "se arriva Sol maggiore allora prova Re", il modello ha imparato distribuzioni di probabilità da esempi.
La softmax che chiude normalmente una predizione trasforma i punteggi interni in probabilità p_i = e^(s_i/T) / Σe^(s_j/T), dove T è una temperatura che possiamo pensare grossolanamente come una manopola fra prudenza ed avventura. Con temperatura più bassa il modello preferisce ciò che considera più probabile, con temperatura più alta esplora alternative meno ovvie. Ed improvvisamente anche la creatività apparente acquista una faccia matematica: non significa che l'emozione sia una formula, significa che il modello può scegliere fra moltissime continuazioni possibili invece di riprodurre sempre quella più comune.
Diffusion: partire dal rumore e togliere ciò che non appartiene alla canzone
La seconda grande famiglia utilizza un meccanismo quasi opposto e personalmente lo trovo ancora più spettacolare da spiegare. Un diffusion model viene addestrato prendendo una rappresentazione musicale pulita x0 ed aggiungendo progressivamente rumore fino ad arrivare ad una versione xt nella quale gran parte dell'informazione originale è stata distrutta. Una forma semplificata del processo è xt = √αt x0 + √(1-αt) ε, con ε che rappresenta rumore casuale.
Durante l'addestramento la rete impara il problema inverso, cioè dato xt, il passo temporale t ed il prompt, stimare quale parte sia rumore e quale struttura appartenga ad un audio plausibile. Alla generazione parto praticamente dal caos ed applico ripetutamente il denoising fino a fare emergere una rappresentazione che soddisfa il condizionamento.
Lyria 3.5 dichiara espressamente di utilizzare latent diffusion su latenti audio temporali, Stable Audio 3.0 usa una architettura di latent diffusion sopra SAME (Semantically-Aligned Music Autoencoder), un autoencoder che cerca di conservare insieme qualità acustica e struttura semantica. Il vantaggio di lavorare nel latente è enorme: invece di modellare milioni di campioni audio, opero su una rappresentazione compressa nella quale vicinanze e direzioni hanno già imparato a descrivere parti significative del suono.
Ed è anche qui che il testo entra nella musica. Il prompt viene trasformato in embedding, cioè vettori numerici, e l'architettura impara durante l'addestramento ad associare regioni del linguaggio a strutture dell'audio. "Piano jazz intimo, voce roca maschile, 72 BPM, batteria spazzolata" non viene convertito in quattro interruttori ma in una geometria di caratteristiche che condiziona il processo generativo.
La cosa difficile non è fare dieci secondi belli, è ricordarsi perché esistono
Per moltissimo tempo la musica generata aveva un difetto che si sentiva dopo pochi secondi: localmente era credibile ma non sembrava sapere dove stesse andando. Una canzone umana possiede una struttura gerarchica, una battuta appartiene ad una frase, una frase appartiene ad una strofa, la strofa prepara un ritornello, il ritornello ritorna abbastanza simile da essere riconoscibile ma non necessariamente identico, ed un bridge può introdurre materiale nuovo proprio perché l'ascoltatore ha ormai imparato quello precedente.
Questa persistenza a lungo termine è matematicamente difficile perché il modello deve conservare dipendenze su scale temporali molto diverse. Deve ricordare che tre minuti fa ha introdotto un motivo di tre note e contemporaneamente decidere quale transient della batteria generare nei prossimi millisecondi. La ricerca MIR (Music Information Retrieval) ha mostrato da anni quanto ripetizione, gerarchia ed interazione fra ritmo, armonia e melodia siano centrali nella struttura delle canzoni umane, ed i primi generatori profondi differivano parecchio da questa organizzazione.
Nel 2026 il salto è evidente. Suno v6 arriva ad otto minuti in una singola generazione, Stable Audio 3.0 Medium e Large superano sei minuti, Lyria 3.5 arriva a tre minuti ed è stato migliorato proprio su musicalità, struttura, testi e voce, mentre Udio può costruire brani più lunghi attraverso estensioni successive. Ma durata e coerenza NON SONO LA STESSA COSA: un modello può produrre otto minuti di audio senza mantenere otto minuti di intenzione musicale perfettamente coerente.
I sistemi più recenti cercano di risolvere il problema con contesti più lunghi, rappresentazioni migliori, timing conditioning, editing locale e meccanismi che conservano una parte del brano mentre ne rigenerano un'altra. Stable Audio 3.0 genera durata variabile ed introduce continuation ed inpainting, mentre Suno v6 permette di cambiare una singola parte lasciando il resto invariato. Questo secondo me è il cambiamento più importante: invece di pretendere che la AI indovini un capolavoro in un colpo solo, la stiamo trasformando in uno strumento ITERATIVO, esattamente come una DAW (Digital Audio Workstation).
Ed arriviamo alla domanda divertente: se canto stonato come una campana
Qui la risposta nel 2026 è sorprendente ma bisogna dirla bene. Se registro sul telefono una melodia stonata, rumorosa e cantata male, una AI moderna può spesso usarla come seme per costruire una canzone credibile, ma non esiste una garanzia che capisca esattamente LA MELODIA CHE AVEVO IN TESTA.
Suno v6 dichiara esplicitamente che posso canticchiare una melodia, registrare un riff oppure cantare una strofa e chiedergli di costruirci intorno una composizione completa. Con v5.5 aveva già introdotto Voices, che permette di registrare oppure caricare la propria voce e farla cantare nelle creazioni. Udio può usare audio caricato per Extend, Remix, Style ed Inpaint, anche se la sua stessa documentazione avverte che gli upload a cappella puri non funzionano ancora particolarmente bene. Stable Audio 3.0 può trasformare audio esistente, conservarne alcuni elementi e cambiare stile oppure continuarlo.
Quindi sì, il famoso memo vocale registrato in macchina può ormai diventare batteria, basso, armonia, chitarre, archi ed una voce intonata. Ma bisogna capire che il modello può fare due lavori diversi e non sempre l'interfaccia ci dice chiaramente quale dei due stia facendo: CORREGGERE la nostra melodia oppure REINTERPRETARLA.
Come fa a capire che cosa volevo cantare se ero fuori nota
Qui entra in scena una matematica molto più vecchia dell'AI. La frequenza fondamentale della voce, F0, può essere stimata dal segnale attraverso autocorrelazione, metodi spettrali oppure reti neurali. Una volta stimata una frequenza f posso convertirla nel sistema delle note MIDI con m = 69 + 12 log2(f/440). Il La a 440 Hz diventa 69, un'ottava sopra a 880 Hz diventa 81 perché ogni ottava raddoppia la frequenza, mentre un semitono corrisponde ad un rapporto 2^(1/12), circa 1,05946.
Se canto un La a 450 Hz invece di 440 posso calcolare l'errore in cent con 1200 log2(450/440), che vale circa 39 cent, meno di mezzo semitono. Un pitch corrector tradizionale può semplicemente spingere quella frequenza verso la nota consentita più vicina. Una AI generativa può fare qualche cosa di più interessante, perché osserva anche ciò che viene prima e dopo, il ritmo, il profilo melodico, il testo ed eventualmente l'armonia che sta costruendo.
Se il mio canto passa grossolanamente da una nota bassa ad una più alta e poi torna giù, anche se nessuna delle tre è perfettamente intonata, il CONTORNO contiene informazione. La rete può inferire che probabilmente non intendevo usare esattamente quelle frequenze ma una sequenza compatibile con la scala e con la statistica delle melodie che conosce. Ed ecco perché una persona stonata può dare comunque una informazione musicale utile: non deve fornire il numero esatto della nota, può fornire altezza relativa, ritmo, durata, accenti e fraseggio, lasciando al modello il compito di trovare una realizzazione armonicamente plausibile.
Ma se il cantato è talmente ambiguo che il sistema non distingue più quali variazioni siano intenzionali e quali errori, entra in gioco P(melodia | audio, prompt, contesto) e possono esistere più soluzioni quasi altrettanto probabili. La AI non può leggere la canzone che avevamo nel cervello, può soltanto ricostruire quella che spiega meglio ciò che ha ricevuto. Per questo se voglio preservare una melodia con precisione continuo a preferire MIDI oppure una registrazione abbastanza leggibile, ed è interessante che Suno nel settembre 2026 abbia migliorato proprio la trasformazione da MIDI ad audio dentro Studio.
La voce artificiale non è semplicemente un sintetizzatore incollato sopra la base
Una delle cose che più impressionano nei generatori recenti è che voce ed arrangiamento sembrano appartenere alla stessa esecuzione. La cantante rallenta, respira, apre le vocali nel ritornello, raddoppia una frase e compare un coro proprio quando l'arrangiamento cresce. In molti sistemi moderni questo è possibile perché la voce non viene necessariamente costruita come una traccia completamente separata dopo avere finito la base, il modello impara distribuzioni sull'audio musicale completo oppure su rappresentazioni nelle quali sorgenti diverse rimangono fortemente correlate, quindi voce, batteria, armonia e produzione possono essere generate in maniera congiunta oppure fortemente condizionata.
Naturalmente nei prodotti commerciali Suno ed Udio l'architettura interna completa non è pubblica e sarebbe scorretto inventarla. Sappiamo però che le funzioni esposte ormai trattano voce, testo, stile e struttura come dimensioni controllabili. Lyria 3.5 ha migliorato proprio espressività vocale, pronuncia e struttura dei testi, Suno v6 comprende indicazioni su vocals, instrumentation e song structure, mentre v5.5 permette perfino di costruire Custom Models caricando almeno sei tracce della propria produzione.
Questo significa che stiamo passando dalla voce sintetica generica alla IDENTITÀ MUSICALE PERSONALIZZATA, che è tecnicamente meravigliosa e giuridicamente parecchio più complicata.
Anche il testo deve incastrarsi dentro la musica
Far cantare una poesia non significa semplicemente leggere le parole sopra una base. Il modello deve decidere quante sillabe starebbero bene in una battuta, dove cade l'accento tonico, quali vocali possono sostenere una nota lunga, dove inserire una pausa ed in quale punto una consonante diventerebbe impronunciabile ad alta velocità.
Da un punto di vista statistico posso pensare alla voce come ad un altro problema condizionato: P(audio vocale | testo, melodia, tempo, stile, contesto). Ma fra testo ed audio esiste un allineamento temporale che il modello deve imparare, perché la stessa frase può essere cantata in un secondo oppure in otto, con divisioni ritmiche completamente diverse.
I modelli recenti sono migliorati molto proprio nella structural awareness. Lyria riconosce richieste come intro, verse, chorus e bridge, Suno v6 permette di sostituire una singola parola senza rifare necessariamente l'intera canzone ed i sistemi di editing stanno trasformando il testo in una specie di interfaccia semantica della DAW.
Io posso quindi scrivere "nel secondo ritornello togli la batteria per due battute, fai entrare un coro gospel e sostituisci love con light" ed il problema non è più generare musica da zero, ma LOCALIZZARE una regione semantica della canzone e rigenerarla mantenendo coerenza con tutto ciò che la circonda.
Il vero miracolo statistico è l'arrangiamento
Se una AI mi propone una progressione Do-Sol-La minore-Fa non sono particolarmente impressionato, perché è una delle successioni più comuni della musica pop. Quello che trovo impressionante è che sopra quegli accordi sappia decidere quando il basso debba smettere di seguire la tonica, quando la batteria debba aprire il charleston, quando una chitarra debba diventare più larga nello stereo e quando inserire un controcanto senza schiacciare la voce.
Queste decisioni derivano dalla statistica congiunta di moltissime variabili. Non impariamo soltanto P(accordo successivo | accordi precedenti), ma correlazioni fra armonia, timbro, densità, dinamica, metrica, struttura e produzione. Un ritornello pop non è soltanto un insieme di note, statisticamente tende ad avere più densità, più banda occupata, una voce più aperta, raddoppi, riverberi oppure armonizzazioni che lo rendono percettivamente più grande della strofa.
Il modello non sa necessariamente formulare a parole "ora devo aumentare la densità spettrale fra 2 e 8 kHz per far sembrare il chorus più brillante", ma durante l'addestramento quella relazione può essere incorporata nei pesi perché i ritornelli del training tendono a contenere proprio certe trasformazioni. È per questo che una buona generazione sembra arrangiata e non semplicemente composta.
Ma sta copiando oppure ha imparato?
Qui arriviamo alla domanda inevitabile, ed il problema è molto più serio di uno slogan a favore oppure contro le AI. Tecnicamente un modello generativo non funziona normalmente cercando nel database una canzone e tagliandone pezzi da incollare. Impara una distribuzione statistica e genera una nuova traiettoria dentro quella distribuzione. Ma da questa frase NON segue che sia matematicamente impossibile copiare, ma lo è in modo molto simile a quanto lo sarebbe stato se a scrivere la musica fosse stato un umano.
Riprendiamo il modello autoregressivo. La probabilità di una sequenza esatta di token è P(z1...zT) = ∏ P(zt | z<t). Se ogni passo contenesse, poniamo, 5 bit di entropia effettiva ed avessi mille decisioni davvero indipendenti, una particolare sequenza avrebbe un ordine di probabilità vicino a 2^(-5000), praticamente zero. Questa è l'intuizione che porta a dire che una lunga canzone identica non dovrebbe apparire per puro caso.
Ma le decisioni NON sono indipendenti, l'entropia non è costante ed soprattutto un modello può memorizzare. Se durante l'addestramento una sequenza viene vista molte volte oppure viene appresa con eccessiva precisione, le probabilità condizionate lungo QUEL percorso possono diventare enormemente più alte, quindi il prodotto non è più quello di mille scelte libere. Una sequenza memorizzata può avere un canale privilegiato attraverso il modello.
Ed il plagio musicale non richiede nemmeno una copia bit-per-bit. Una registrazione può avere timbro, batteria e tonalità differenti mantenendo una melodia molto simile, oppure può conservare ritmo ed armonia cambiando il resto. Per questo la ricerca sta costruendo metriche che separano melodia, armonia, ritmo, voce e timbro. Nel 2026 il dataset MATCHA ha raccolto giudizi di esperti proprio su queste dimensioni ed ha mostrato che la similarità percepita dagli esseri umani si allinea soltanto parzialmente alle metriche automatiche.
Quindi la risposta matematica breve è questa: una copia esatta lunga ottenuta per puro campionamento casuale è estremamente improbabile, MA LA MEMORIZZAZIONE PUÒ CAMBIARE DRASTICAMENTE QUELLA PROBABILITÀ e la somiglianza musicalmente rilevante non coincide affatto con l'identità del file audio.
Quattro accordi uguali non dimostrano che qualcuno abbia rubato una canzone
C'è poi il problema opposto. La musica utilizza un vocabolario finito e fortemente non uniforme, alcune progressioni, ritmi e movimenti melodici sono enormemente più comuni di altri. Se estraggo quattro accordi secondo la distribuzione reale della musica pop, la probabilità di collisione con qualche canzone esistente è molto più alta di quanto sarebbe scegliendo uniformemente fra tutte le combinazioni teoriche.
In termini statistici non posso quindi osservare una coincidenza ed urlare immediatamente plagio. Devo chiedermi quanto quella sequenza fosse rara PRIMA di averla vista. Una frase di tre note su una scala pentatonica possiede pochissima informazione e migliaia di compositori possono arrivarci indipendentemente, mentre una lunga sequenza con intervalli, ritmo, accenti ed armonizzazione molto particolari contiene molta più informazione e diventa meno plausibile come coincidenza.
È praticamente un problema di likelihood ratio: quanto è probabile osservare questa somiglianza se i due brani sono indipendenti e quanto sarebbe probabile se uno derivasse dall'altro. MiRA, presentato a ISMIR, nasce proprio per valutare la replicazione dei dati di training usando più metriche di similarità sull'audio, mentre MATCHA aggiunge il giudizio umano separato su attributi musicali differenti. La direzione secondo me è quella giusta: invece di discutere in astratto se la AI "copia", dobbiamo MISURARE CHE COSA È SIMILE, QUANTO È RARO E DOVE POTREBBE PROVENIRE.
E va tenuto separato un altro problema ancora, ossia con quali dati il modello sia stato addestrato. Posso avere un output originale ma un dataset contestato, oppure un dataset perfettamente licenziato ed un output accidentalmente troppo simile ad una canzone. Stability AI dichiara Stable Audio 3.0 addestrato su dati completamente licenziati, Meta dichiarava MusicGen addestrato su musica posseduta oppure specificamente concessa in licenza, Suno v6 è stato sviluppato con partner dell'industria ed Udio ha concluso accordi con Warner ed Universal. Sono questioni giuridiche distinte dal semplice calcolo della somiglianza dell'output.
Nel 2026 il generatore sta diventando una DAW
La tendenza più chiara che vedo negli ultimi mesi è questa. Nel 2023 il prodotto era il pulsante Generate, nel 2026 il prodotto sta diventando l'EDITOR.
Suno Studio 2.0 porta il lavoro dentro una DAW nel browser, permette di lavorare su stem, arrangiare ed intervenire localmente, mentre l'aggiornamento di settembre ha migliorato parecchio la generazione a partire da MIDI. Suno v6 può sostituire una sezione con una descrizione in linguaggio naturale, combinare fonti multiple, isolare una parte, campionarla e costruirci un beat intorno. Stable Audio 3.0 supporta inpainting su segmenti singoli oppure multipli e continuation. Udio Sessions lavora sulla forma d'onda ed permette estensioni e sostituzioni non distruttive.
Questo secondo me cambia anche il rapporto con il musicista. Il generatore one-shot tende a sostituire il processo, l'editor generativo invece può entrarci dentro. Il compositore può tenere la propria melodia, cambiare soltanto l'orchestrazione, generare dieci possibili bridge, sostituire il basso, chiedere un coro oppure trasformare un vecchio MIDI in audio realistico.
Non stiamo cioè andando soltanto verso "premi un bottone e ricevi una canzone", ma verso "PARLA CON LA CANZONE MENTRE LA STAI COSTRUENDO".
Un'altra tendenza stranissima: il modello può avere il mio gusto
Suno v5.5 ha introdotto Custom Models addestrabili caricando almeno sei tracce del proprio catalogo e My Taste, che impara generi, mood e riferimenti preferiti. Udio ha Styles e Style Blending, con uno oppure due riferimenti audio che descrivono il carattere del brano più efficacemente di cento aggettivi. Il concetto è semplice ma cambia parecchio il prodotto: invece di avere una sola enorme AI musicale per tutti, posso avere un livello di PERSONALIZZAZIONE sopra il modello generale.
Dal punto di vista matematico è un condizionamento ulteriore. Non cerco più soltanto P(musica | prompt), ma qualche cosa più vicino a P(musica | prompt, profilo creativo, riferimenti, voce, catalogo personale). Lo spazio delle possibilità viene ristretto verso ciò che il sistema ha imparato essere il mio gusto.
È potente, ma apre un tema enorme sull'identità artistica. Se posso personalizzare legalmente un modello sulle mie canzoni è un'estensione naturale del mio studio, se posso farlo sul catalogo di qualcun altro senza consenso sto costruendo una macchina di imitazione. Ed è proprio per questo che nel 2026 le piattaforme stanno mettendo sempre più enfasi su opt-in, licensing, controlli sugli upload ed attribution.
Qui la scala del fenomeno smette di essere una curiosità per tecnici. Deezer ha comunicato che nel giugno 2026 le tracce individuate come completamente generate da AI hanno superato al picco il 50% dei nuovi upload giornalieri, circa 90.000 brani al giorno. Attenzione, non significa che metà della musica ASCOLTATA sia artificiale, perché sulla piattaforma rappresenta soltanto fra l'1 ed il 3% degli stream anche per effetto delle politiche di raccomandazione, ma significa che il costo marginale di produrre una registrazione musicale è praticamente crollato.
Questa è una trasformazione economica prima ancora che artistica. Se una persona oppure un bot può creare in un giorno più tracce di quante un musicista tradizionale potrebbe registrare in anni, il problema non è soltanto chi compone meglio, ma come filtriamo quantità astronomiche di contenuto, come assegniamo royalties, come riconosciamo gli artisti reali e come impediamo che lo streaming fraudolento trasformi un sistema creativo in una macchina per produrre rumore monetizzabile.
Spotify nell'agosto 2026 ha introdotto una etichetta specifica per gli artisti generati tramite AI, mentre Deezer tagga la musica AI ed ha sviluppato sistemi di rilevazione dedicati. La domanda "questa canzone è bella" sta quindi venendo affiancata da un'altra domanda che fino a tre anni fa sembrava assurda: CHI O CHE COSA È L'ARTISTA CHE STO ASCOLTANDO.
Anche il prompt sta diventando una partitura testuale
Con Lyria 3.5 posso descrivere BPM, tonalità, tipo di batteria, strumentazione, timbro vocale, disposizione delle parti e durata, ed il modello è stato migliorato proprio nell'aderenza a queste istruzioni. Questo significa che il prompt musicale sta diventando sempre meno simile ad un desiderio generico e sempre più simile ad una partitura scritta con il linguaggio naturale.
Posso specificare "82 BPM, groove MPC swingato, voce maschile baritonale, Rhodes, chorus con armonie sovrapposte" e la AI deve tradurre parole in relazioni temporali e spettrali reali. In termini geometrici il text encoder costruisce un vettore c e la generazione cerca regioni del latent space compatibili con quel vettore, ma non esiste un asse semplice chiamato "baritono" oppure "MPC swing". Sono concetti distribuiti in molte dimensioni.
Ed è probabilmente questo uno dei motivi per cui i modelli musicali sono diventati così convincenti improvvisamente: non hanno imparato soltanto il suono, hanno imparato un ponte sempre migliore fra IL LINGUAGGIO CON CUI NOI DESCRIVIAMO LA MUSICA e la geometria matematica con la quale loro la rappresentano.
La statistica non rende la musica meno emozionante
Ogni volta che si spiega la matematica dietro questi sistemi qualcuno arriva alla conclusione che allora non ci sia creatività, perché "fa soltanto statistica". Ma anche il cervello umano fa continuamente previsioni, riconosce regolarità, forma aspettative ed impara distribuzioni dall'esperienza, pur usando un meccanismo biologico completamente diverso.
Quello che la spiegazione statistica ci dice non è se una canzone abbia valore artistico, ci dice COME il sistema riesca a produrre una successione coerente senza avere nel proprio codice una regola per ogni nota. Il modello ha imparato che certe tensioni chiedono statisticamente una risoluzione, che certe sincopi appartengono più spesso ad alcuni groove, che certi timbri convivono bene e che una melodia può deviare dalla scala in modi che il contesto rende significativi.
Poi campiona.
Ed in quel campionamento compare qualche cosa che non era memorizzato come brano completo ma che rimane compatibile con una enorme distribuzione di cose che abbiamo già chiamato musica.
Ed allora torniamo al mio cantato da campana
La cosa che per me riassume meglio tutta questa rivoluzione è immaginare una persona che non sappia suonare nessuno strumento e non sappia intonare una nota con precisione, ma abbia in testa una idea melodica. Fino a pochi anni fa avrebbe dovuto descriverla ad un musicista oppure imparare abbastanza teoria e software da trasformarla in note.
Oggi può canticchiarla.
La macchina estrae informazioni sul pitch e sul ritmo, confronta statisticamente quel profilo con strutture musicali apprese, ricostruisce una possibile melodia intonata, immagina armonia ed accompagnamento, genera timbri e voce, organizza sezioni ed infine sintetizza direttamente l'onda sonora. Se il risultato non è quello desiderato non deve necessariamente ricominciare tutto, può indicare una regione e chiedere di cambiare.
Non è telepatia ed a volte la AI capirà una melodia diversa da quella che avevamo in testa. Ma siamo arrivati al punto nel quale UNA INTENZIONE MUSICALE MOLTO IMPERFETTA PUÒ DIVENTARE UNA PRODUZIONE COMPLETA SENZA PASSARE OBBLIGATORIAMENTE ATTRAVERSO LA TECNICA STRUMENTALE.
Ed è questo, molto più del fatto che una rete sappia imitare una chitarra, che secondo me rende le AI musicali una tecnologia enorme. Stanno separando sempre di più l'atto di IMMAGINARE MUSICA dall'atto fisico e tecnico necessario per realizzarla, facendo entrare nella composizione milioni di persone che fino a ieri potevano soltanto ascoltare. Con tutta la meraviglia, i problemi economici, il rischio di copie, la montagna di musica inutile ed i conflitti sul copyright che inevitabilmente ne seguiranno, ma ormai il passaggio è avvenuto: POSSIAMO CANTARE STONATI COME UNA CAMPANA ED AVERE COMUNQUE UN'ORCHESTRA CHE CI SEGUE!


Commenti
Nessun commento, per ora.
Per commentare serve un accesso. Qui siamo tutti tecnici e colleghi!
Accedi per commentare