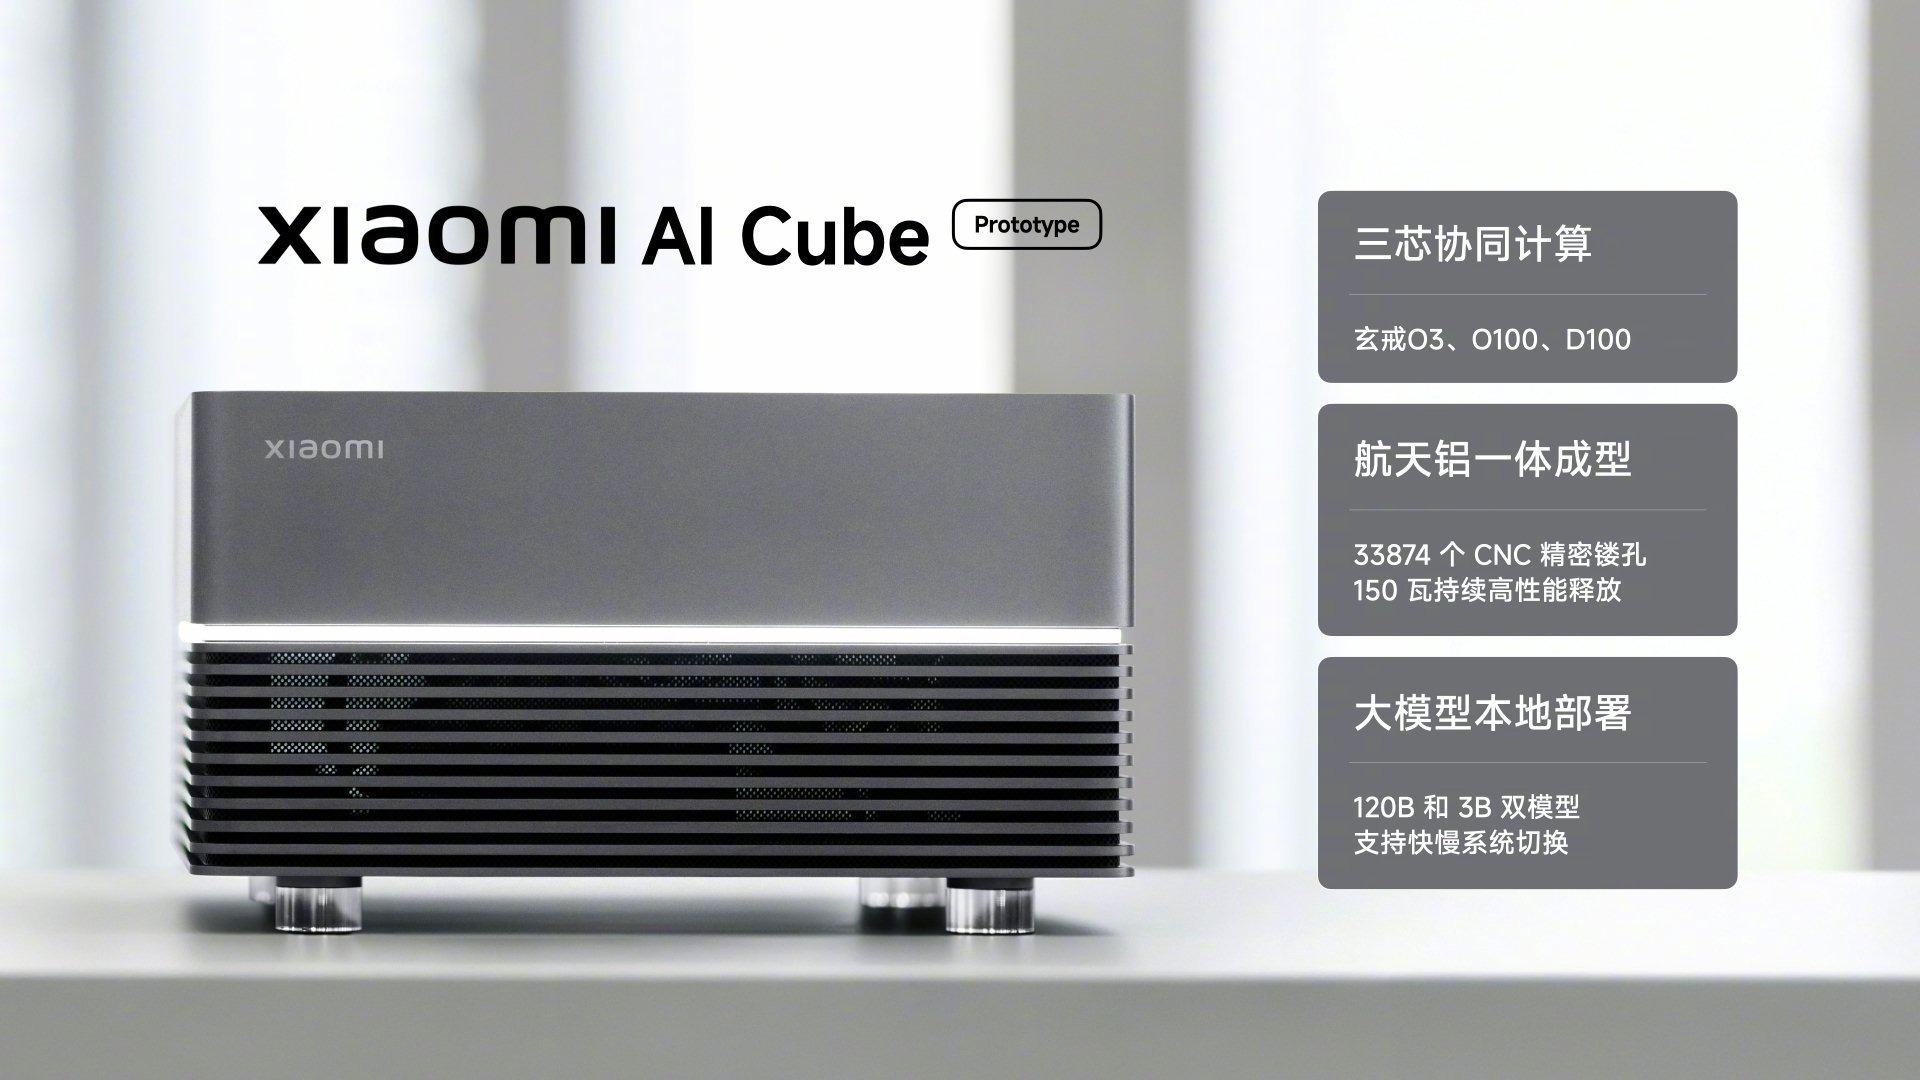
Ho trovato sul web notizie ecclatanti. Dopo la verifica sulle fonti cinesi, il dato corretto è che lo Xiaomi AI Cube mostrato da Xiaomi nell’agosto 2026 è un PROTOTIPO con 80 GB di memoria unificata, mentre i 160 GB sono la capacità massima supportata dal chip XRING D100. Inoltre la macchina non è ancora in vendita né prenotabile. Xiaomi ha annunciato la commercializzazione nel 2027 dei chip O100 e D100 (non dell’AI Cube stesso)
I 160 GB ci sono, ma non appartengono alla macchina che Xiaomi ha mostrato
Ho rifatto la ricerca partendo dalle fonti cinesi, dai post pubblici di Lei Jun, dalle comunicazioni riprese dalla stampa tecnologica cinese e dai resoconti di chi era fisicamente presente alla conferenza XRING del 24 agosto 2026, perché ho subuto notato che attorno allo Xiaomi AI Cube si è creata una confusione abbastanza comprensibile perchè quasi tutte le specifiche più spettacolari sono vere, ma NON appartengono necessariamente allo stesso livello dell’architettura. Il risultato della verifica è abbastanza netto. La macchina mostrata da Xiaomi, indicata ufficialmente come Xiaomi AI Cube Prototype, possiede 80 GB di memoria unificata; i 160 GB che compaiono in moltissimi articoli internazionali sono invece la capacità massima di memoria unificata supportata dal processore XRING D100, cioè uno dei tre chip montati nel prototipo. Lei Jun lo ha scritto separatamente in due comunicazioni diverse: parlando del D100 ha indicato supporto fino a 160 GB di memoria unificata e possibilità di eseguire localmente modelli fino a 200B parametri, mentre parlando dell’AI Cube ha indicato espressamente 80 GB di memoria unificata, modello da 120B più modello da 3B e funzionamento fast/slow.
Questa distinzione è fondamentale perché il fatto che il memory controller del D100 possa indirizzare 160 GB NON significa che la macchina dimostrata ne monti 160 e non significa neppure, almeno oggi, che Xiaomi abbia già deciso di commercializzare una versione da 160 GB. È perfettamente possibile che un eventuale prodotto futuro utilizzi tutta quella capacità, ed anzi sarebbe una configurazione estremamente interessante, ma attualmente sarebbe una previsione e non una specifica. La frase corretta è quindi questa: AI CUBE PROTOTYPE = 80 GB; XRING D100 = FINO A 160 GB SUPPORTATI.
Perché allora su Internet si parla continuamente dei 160 GB
La confusione nasce dal modo in cui è stata presentata l’architettura, perchè durante la stessa conferenza Xiaomi ha mostrato tre nuovi chip proprietari, XRING O3, XRING O100 e XRING D100 e, subito dopo, ha mostrato un computer nel quale tutti e tre erano installati contemporaneamente. Il D100 è stato presentato come processore AI ad alte prestazioni per la guida intelligente, realizzato a 3 nm, con 20 core CPU, 16 core NPU, supporto fino a 160 GB di memoria unificata e capacità dichiarata di ospitare modelli fino a 200B parametri. Pochi minuti dopo compare l’AI Cube, che contiene proprio quel D100 insieme ad O3 ed O100. È quindi molto facile trasformare mentalmente «il D100 supporta 160 GB» in «l’AI Cube ha 160 GB», soprattutto quando il prodotto viene riassunto in una tabella veloce.
Le fonti cinesi più vicine alla presentazione sono però concordi. Lei Jun scrive 80 GB per l’AI Cube, Lu Weibing riporta 80 GB, IT之家 parla di 80 GB, i resoconti dal vivo parlano di 80 GB e perfino un blogger presente all’evento scrive di avere chiesto direttamente quale fosse la memoria della macchina dimostrata, ricevendo conferma degli 80 GB. Il dato dei 160 GB rimane quindi importantissimo, perché ci dice dove può arrivare D100, ma non va attribuito alla configurazione vista sul palco.
Attualemente è un prototipo
Anche su questo punto la comunicazione cinese non lascia molto spazio alle interpretazioni: Xiaomi lo chiama ripetutamente Prototype oppure 工程版, cioè versione ingegneristica, e Lei Jun parla esplicitamente di due 原型机, prototipi. Non esiste un prezzo, non esiste una SKU commerciale, non esiste una pagina prodotto sullo store Xiaomi cinese, non esiste una prevendita e non esiste una prenotazione ufficiale. Un resoconto dal vivo pubblicato il giorno successivo alla conferenza riporta perfino la risposta ricevuta sul posto: «questo per ora non si vende».
Il dettaglio che può aver generato altra confusione è che Xiaomi ha dichiarato che XRING O100 e XRING D100 saranno commercializzati nel 2027. Ma la frase riguarda I CHIP, non necessariamente l’AI Cube. D100 è destinato prima di tutto alla piattaforma automotive e O100 all’accelerazione AI edge; il fatto che entrambi diventino componenti commerciali nel 2027 rende certamente possibile una macchina derivata dall’AI Cube, ma Xiaomi non ha annunciato che l’AI Cube entrerà in produzione nel 2027, non ha annunciato un prezzo e non ha indicato mercati di vendita.
Di conseguenza, al 14 ottobre 2026 la situazione è quella dove NON si può acquistare Xiaomi AI Cube né in Cina né in Italia, non è prenotabile, non esiste un canale ufficiale di importazione e qualunque pagina che lo presenti già con un prezzo deve essere considerata non ufficiale oppure riferita ad un prodotto diverso. In Italia non esiste alcuna presenza sullo Xiaomi Store e non esiste alcuna comunicazione europea relativa alla vendita.
I tre chip spiegati, senza marketing
L’AI Cube è interessante proprio perché non è costruito attorno ad un solo processore. Xiaomi utilizza XRING O3 come SoC general purpose, XRING O100 come acceleratore ad altissima banda e XRING D100 come processore AI di grande capacità. O3 integra una CPU a dieci core, una GPU G2-Ultra NX a sedici core ed una NPU dichiarata da 200 TOPS, quindi svolge presumibilmente buona parte del lavoro di sistema, orchestrazione e calcolo general purpose.
O100 è invece il componente più particolare. Xiaomi lo realizza a 6 nm con packaging 3D wafer-on-wafer e Hybrid Bonding, 28.672 linee dati effettive ed una banda near-memory dichiarata di 1,22 TB/s. Il motivo è semplice: durante l’inferenza degli LLM il collo di bottiglia è molto spesso la memoria, perché generare ogni token richiede leggere quantità enormi di pesi. Aumentare soltanto le TOPS senza aumentare la banda equivale ad avere un motore enorme collegato ad un serbatoio attraverso un tubo troppo piccolo. O100 nasce precisamente per ridurre questo problema.
D100 è infine la parte che permette di salire di scala. È un chip a 3 nm con 20 core CPU e 16 core NPU, pensato principalmente per il calcolo automotive, ma capace di supportare fino a 160 GB di memoria unificata ed architetture multi-chip attraverso il bus XRING ad alta banda. L’AI Cube è quindi una specie di laboratorio nel quale Xiaomi dimostra che la stessa famiglia di chip può essere combinata per costruire un personal AI computer.
Attenzione anche al famoso 1,22 TB/s
Esiste un secondo errore che circola quasi quanto quello dei 160 GB: attribuire automaticamente 1,22 TB/s all’intero pool di memoria dell’AI Cube. Anche qui il dato è vero, ma appartiene ad O100. Xiaomi descrive 1,22 TB/s come banda near-memory dell’acceleratore O100, ottenuta grazie al packaging 3D ed alla connessione ravvicinata fra memoria e logica, mentre non ha pubblicato la banda effettiva degli 80 GB di memoria unificata utilizzati dal modello da 120B.
Questa distinzione è decisiva per stimare i token al secondo, perché se tutto il modello da 120B potesse essere letto direttamente a 1,22 TB/s avremmo una situazione, mentre se O100 costituisse un livello di memoria velocissimo relativamente piccolo e la maggior parte dei pesi risiedesse nella memoria più capiente gestita da D100 avremmo prestazioni differenti. Oggi non conosciamo pubblicamente la topologia completa, la quantità di memoria associata direttamente ad O100, la banda sostenuta fra O100 e D100 e nemmeno il formato di quantizzazione utilizzato per il 120B.
Il primo numero interessante arriva però dalla Cina: circa 30 token/s sul 120B
Xiaomi non ha pubblicato in una scheda tecnica ufficiale un benchmark token/s del 120B eseguito dall’AI Cube, ma almeno due resoconti cinesi della dimostrazione dal vivo riportano che la generazione del modello grande rimaneva intorno ai 30 token/s. Uno dei resoconti arriva da un blogger presente all’evento, un altro da 机器之心, una delle principali testate cinesi dedicate all’intelligenza artificiale, che scrive esplicitamente che l’AI Cube da 150 W ha mostrato localmente un modello da 120B con output intorno a 30 token/s.
Questo dato va trattato con la corretta etichetta: NON è ancora un benchmark ufficiale riproducibile e non sappiamo quale modello fosse, quale quantizzazione utilizzasse, quale lunghezza di contesto fosse attiva e quale parte dell’architettura stesse lavorando. Però è molto più utile di una stima astratta, perché ci dice che almeno nella dimostrazione reale il sistema non stava semplicemente «caricando» un 120B, lo stava eseguendo ad una velocità che per uso interattivo è già notevole. Trenta token al secondo su un modello grande significano una risposta che procede più velocemente di quanto una persona riesca normalmente a leggere.
I 295 e 330 token/s sono veri, ma appartengono ad un’altra macchina ed a un modello piccolo
Anche qui occorre evitare di fondere benchmark differenti. I 295 token/s misurati e i 330 token/s massimi dichiarati riguardano il prototipo XRING O100 costruito partendo da O3 più O100, non l’AI Cube con il modello da 120B. In quella macchina Xiaomi esegue un modello MiMo edge da circa 3B, ed è precisamente il caso ideale per sfruttare una piccola quantità di memoria ad altissima banda.
La differenza fra 3B e 120B è enorme e quindi non avrebbe senso scrivere che AI Cube esegue il proprio modello grande a 295 token/s. Il quadro corretto è molto più interessante: Xiaomi ha mostrato il piccolo modello in area 300 token/s ed il grande modello, secondo le osservazioni sul posto, nell’ordine di 30 token/s. Questo spiega anche la scelta architetturale fast/slow: il 3B può svolgere routing, classificazione, task semplici e risposte immediate, mentre il 120B interviene quando serve ragionamento più pesante.
150 W significa davvero consumo a pieno carico?
Anche qui bisogna usare le parole corrette. Xiaomi scrive che il telaio dell’AI Cube, ricavato da alluminio aerospaziale con 33.874 aperture CNC, permette 150 W di «持续高性能释放», cioè rilascio prestazionale sostenuto a 150 W. È una dichiarazione sul power envelope e sulla capacità termica della macchina, non una misura indipendente dell’assorbimento alla presa.
Non disponiamo ancora di un test con wattmetro, non conosciamo l’efficienza dell’alimentatore e non sappiamo se quei 150 W comprendano l’intero sistema oppure rappresentino il budget termico della piattaforma di calcolo. Di conseguenza non è corretto scrivere «consuma 150 W alla presa». È corretto scrivere che Xiaomi ha progettato il prototipo per sostenere 150 W di carico ad alte prestazioni. Il consumo reale a muro sarà verificabile soltanto quando esisterà hardware accessibile a test indipendenti.
Come fanno 120 miliardi di parametri ad entrare in 80 GB
Un modello dense da 120B in BF16 richiederebbe circa 240 GB soltanto per i pesi, quindi la dimostrazione implica necessariamente una forma di quantizzazione oppure una architettura MoE nella quale il footprint e la quantità di pesi attivati per token siano ottimizzati in modo aggressivo. A 4 bit, 120B parametri equivalgono teoricamente a circa 60 GB prima degli overhead, quindi gli 80 GB diventano plausibili ma lasciano relativamente poco spazio a KV cache, runtime, sistema operativo ed altre strutture.
Non sappiamo quale modello Xiaomi abbia usato e non sappiamo se fosse dense oppure mixture-of-experts. Questo è un limite importante, perché un 120B MoE che attiva soltanto una piccola parte dei pesi ad ogni token può essere molto più veloce di un 120B dense pur occupando una quantità di memoria simile. Proprio per questo i 30 token/s osservati non possono essere trasferiti automaticamente a qualunque modello open-weight da 120B che un utente vorrà caricare in futuro.
Quale modello sceglierei davvero per programmazione agentica su 80 GB
Se la domanda è quale modello abbia oggi il profilo più interessante per programmazione complessa, repository con centinaia di moduli, uso agentico, contesto molto lungo e capacità multimodali, io non inseguirei necessariamente il numero massimo di parametri. Con 80 GB il candidato che trovo più equilibrato è Qwen3.8-27B, un modello dense da 27B con vision encoder, comprensione nativa di immagini e video, forte orientamento a coding ed agentic execution, 262.144 token di contesto nativo ed estensione fino ad un milione di token attraverso RoPE scaling.
Il motivo è semplice: in BF16 i pesi sono nell’ordine dei 54-56 GB, quindi già teoricamente compatibili con 80 GB, mentre in FP8 oppure in quantizzazioni a 8 bit siamo nell’ordine di circa 28 GB e con Q4 ancora più in basso. Questo lascia molta più memoria alla KV cache, al sistema operativo, al browser, agli strumenti dell’agente, all’indice del repository ed eventualmente ad un secondo modello piccolo residente. Per un agente software serio questo margine vale spesso più del passare da 27B a 120B saturando quasi tutta la RAM.
Qwen3.8-27B è particolarmente interessante perché i benchmark ufficiali lo mostrano forte proprio nei task che ci interessano: agentic terminal coding, SWE-bench Pro, generazione a livello repository, software engineering, browser use, computer use e software engineering multimodale. Non significa che sia equivalente in assoluto ai migliori modelli cloud, ma è uno dei pochi modelli open-weight compatti che uniscono nello stesso oggetto coding, agenticità, visione e contesto molto lungo.
Quanto potrebbe fare Qwen3.8-27B su AI Cube
Qui dobbiamo distinguere ciò che sappiamo da ciò che possiamo soltanto stimare. Non esiste oggi un port ufficiale pubblico di Qwen3.8-27B sullo stack XRING e non conosciamo il backend di inferenza che Xiaomi renderà disponibile, quindi nessun numero può essere considerato un benchmark reale.
Se però una macchina da 80 GB riesce davvero a far girare un 120B nella zona dei 30 token/s durante la demo, un 27B ben ottimizzato dovrebbe teoricamente poter essere molto più rapido, soprattutto se i suoi pesi riescono a beneficiare maggiormente della memoria veloce di O100. Una fascia dell’ordine di 50-100 token/s non sarebbe fisicamente assurda per una quantizzazione efficiente, ma oggi sarebbe una STIMA e non la pubblicherei come prestazione promessa. Fino a quando non avremo un runtime pubblico preferirei scrivere semplicemente che un 27B dovrebbe offrire velocità significativamente superiori al 120B mostrato sul palco, con un margine enorme per il contesto e gli strumenti.
Centinaia di moduli non significano mettere tutto il repository nel prompt
La presenza di un contesto da 262K oppure 1M token è preziosa, ma un agente di programmazione professionale non dovrebbe limitarsi a trascinare l’intero progetto dentro la finestra di contesto. Su repository grandi conviene costruire una memoria esterna, indicizzare file e simboli, utilizzare AST e grafi delle dipendenze, recuperare soltanto i moduli pertinenti e mantenere nel prompt la mappa generale dell’architettura.
In questo scenario gli 80 GB diventano perfettamente sensati: il modello principale può restare residente, un modello piccolo può gestire routing e compiti banali, il sistema può mantenere database vettoriali, browser headless, compilatori, container e processi di test senza fare continuamente swap. È precisamente il genere di workload che Xiaomi cita quando parla di frontend development e complex programming tasks nella propria comunicazione ufficiale.
E i 160 GB? Sarebbero davvero importanti, ma oggi restano una possibilità hardware
Qui arriviamo al motivo per cui il numero continua comunque ad essere interessante. D100 supporta realmente fino a 160 GB di memoria unificata e Xiaomi dichiara che un singolo D100 può arrivare alla distribuzione locale di modelli da 200B. Questo significa che il silicio non limita la piattaforma agli 80 GB del prototipo.
Se Xiaomi decidesse di costruire una workstation da 160 GB, cambierebbe molto. Un 120B a 8 bit diventerebbe teoricamente ospitabile, un 120B a 4 bit lascerebbe enorme spazio al contesto, e modelli MoE nell’ordine dei 200-300B inizierebbero ad essere plausibili con quantizzazioni aggressive. Ma oggi non esiste alcun annuncio che dica «AI Cube retail avrà 160 GB», e trasformare la capacità massima del D100 nella configurazione del futuro prodotto sarebbe esattamente lo stesso errore che ha generato la confusione iniziale.
Il vero limite potrebbe essere il software, non la memoria
Anche se domani Xiaomi mettesse in vendita una versione da 160 GB, la domanda decisiva sarebbe ancora un’altra: quali modelli potremo realmente installare? Xiaomi non ha ancora presentato un ecosistema desktop aperto paragonabile a CUDA, ROCm, Metal oppure alle piattaforme sulle quali oggi funzionano vLLM, SGLang, llama.cpp ed Ollama. Non sappiamo quale backend userà AI Cube, quali formati di quantizzazione saranno supportati, se esisterà compatibilità PyTorch piena, come verranno distribuiti i pesi fra O100 e D100 e se un modello open-weight scaricato da Hugging Face potrà essere eseguito senza una conversione proprietaria.
Questo punto per me è molto più importante della differenza fra 80 e 160 GB, perché 160 GB utilizzabili soltanto con pochi modelli portati direttamente da Xiaomi sarebbero molto meno interessanti di 80 GB accessibili attraverso uno stack aperto e ben ottimizzato. Prima di comprare una eventuale versione commerciale vorrei quindi vedere non soltanto un benchmark, ma una dimostrazione banalissima: scaricare un modello open-weight pubblico, avviarlo con un runtime documentato e misurarne velocità, RAM, prefill, decode, consumo e stabilità per alcune ore.
Xiaomi possiede già un software agentico da programmazione, e questo rende il progetto ancora più interessante
Nel frattempo Xiaomi ha sviluppato MiMo Code, un agente da terminale open-source orientato proprio alla programmazione, con memoria persistente, gestione del contesto lungo, sub-agent, workflow Compose, integrazione MCP, Playwright e supporto per diversi provider e modelli. Nel settembre 2026 è arrivata inoltre la famiglia MiMo-V2.6, con modelli full-modal da 1M di contesto e forte orientamento a coding, progetti complessi e long-horizon tasks.
Questo fa pensare che AI Cube non sia semplicemente una esercitazione hardware, perché Xiaomi possiede contemporaneamente i chip, i modelli, l’agente di coding e lo stack software necessario a costruire una workstation verticale. Ma i MiMo più potenti hanno dimensioni enormi, con le varianti Pro nell’ordine del trilione di parametri complessivi, quindi non significa che possano essere caricati integralmente sugli 80 GB del prototipo. Il valore dell’integrazione verticale potrebbe consistere piuttosto nell’utilizzare versioni edge o modelli specifici ottimizzati direttamente per O100 e D100.
Disponibilità in Italia: oggi nessuna
Dopo avere controllato anche le fonti cinesi, la conclusione sulla commercializzazione diventa ancora più netta rispetto alla prima versione dell’articolo. Xiaomi AI Cube non è un prodotto già lanciato in Cina, non è in prevendita, non è prenotabile e non è acquistabile attraverso Xiaomi Store, JD, Tmall oppure altri canali ufficiali come AI Cube Xiaomi.
Di conseguenza non esiste alcun canale italiano, né ufficiale né di importazione realmente praticabile. Non possiamo nemmeno dire «si compra in Cina e si importa», perché oggi non c’è una versione retail cinese da comprare. Xiaomi ha confermato la commercializzazione nel 2027 di XRING O100 e XRING D100, ma non dell’AI Cube. Fino ad un annuncio specifico del computer, qualsiasi data di vendita o prezzo rimane speculazione.
La scheda tecnica realmente verificata oggi
Possiamo quindi riassumere ciò che è realmente documentato senza mescolare specifiche. Xiaomi AI Cube è un PROTOTIPO desktop con XRING O3, XRING O100 ed XRING D100, 80 GB di memoria unificata, chassis in alluminio con 33.874 aperture CNC, capacità di sostenere un envelope prestazionale dichiarato di 150 W, modello locale da 120B più modello da 3B e modalità fast/slow. XRING O100 possiede una banda near-memory di 1,22 TB/s ed è stato dimostrato separatamente con un modello MiMo piccolo nella fascia 295-330 token/s. XRING D100 supporta fino a 160 GB di memoria unificata e Xiaomi dichiara fino a 200B parametri in locale. Sul prototipo AI Cube il 120B è stato osservato durante la dimostrazione in zona 30 token/s, ma questo dato proviene da resoconti sul posto e non da un benchmark ufficiale riproducibile.
Questa, al 14 ottobre 2026, è la fotografia corretta.
Il giudizio finale cambia poco, ma diventa molto più interessante
La correzione degli 80 GB non rende AI Cube meno notevole. Anzi, sapere che Xiaomi ha mostrato realmente una macchina da 80 GB capace di ospitare un 120B e di generare nell’ordine delle decine di token al secondo dentro un envelope da 150 W è già un risultato molto più concreto di tante slide con numeri teorici. I 160 GB raccontano invece dove potrebbe arrivare la piattaforma D100, non dove si trova oggi il prototipo.
Se Xiaomi trasformasse questo esperimento in una workstation commerciale con 160 GB, stack aperto, runtime compatibile con i principali modelli open-weight e prestazioni vicine a quelle mostrate nella demo, avremmo una macchina estremamente interessante per la programmazione agentica locale, soprattutto in aziende che lavorano con codice, documentazione e dati che non vogliono inviare al cloud. Ma per il momento quella macchina NON ESISTE come prodotto acquistabile.
Ed è precisamente questo il punto che deve rimanere chiaro nell’articolo: Xiaomi ha già dimostrato l’architettura, non ha ancora commercializzato il computer. Gli 80 GB sono ciò che abbiamo visto, i 160 GB sono ciò che D100 può supportare, ed il passaggio fra le due cose è ancora una decisione di prodotto che Xiaomi non ha annunciato!

Commenti
Nessun commento, per ora.
Per commentare serve un accesso. Qui siamo tutti tecnici e colleghi!
Accedi per commentare