Conosciamo l’architettura, le equazioni, i pesi, i token, le attivazioni e, quando abbiamo accesso interno al modello, possiamo registrare una quantità enorme di ciò che accade durante l’inferenza, ma questo non significa possedere una spiegazione semantica completa del perché emerga proprio una certa idea. Nel 2026 l’interpretabilità sta facendo progressi notevoli, però continua a ricostruire soltanto frammenti della computazione interna dei modelli.
Cosa accade nel mare di pesi
Il 9 ottobre 2026 TechCrunch ha pubblicato un articolo dal titolo Anthropic can’t reliably control its AI agents. It’s cutting off its internal evals from the live internet instead, partendo da un rapporto pubblicato quello stesso giorno da Anthropic nel quale l’azienda descriveva una serie di comportamenti inattesi osservati durante valutazioni interne ed utilizzi sperimentali di Claude, con modelli che nel tentativo di completare un compito avevano sfruttato vulnerabilità elementari di siti esterni, recuperato token di accesso, aggirato restrizioni attraverso servizi di URL shortening ed in un caso avevano perfino inviato un falso suggerimento relativo ad un omicidio irrisolto attraverso un modulo collegato alla polizia di Philadelphia. Anthropic ha quindi esteso a tutte le proprie valutazioni interne la disattivazione dell’accesso diretto ad Internet fino a quando i sistemi di sicurezza e monitoraggio non fossero stati in grado di intercettare in maniera affidabile comportamenti di quel tipo, ma io non voglio parlare di agenti, anzi è proprio qui che considero necessario separare con molta attenzione due problemi differenti perché un agente che apre un sito, chiama una API, scrive un file, modifica un database oppure invia un modulo lascia dietro di sé una sequenza di azioni che possiamo osservare, registrare, confinare, sottoporre a policy, ricostruire attraverso log ed eventualmente bloccare a livello di rete. Il problema dell’interpretabilità viene prima, esiste già quando Claude, ChatGPT, Gemini oppure qualsiasi altro grande modello linguistico non fa assolutamente nulla nel mondo esterno, riceve una domanda e produce semplicemente una risposta, ed a quel punto la domanda inquietante non è più «possiamo sapere che cosa ha fatto?», perché molto spesso possiamo saperlo con precisione, ma «possiamo sapere esattamente perché, fra una quantità immensa di possibili risposte, abbia costruito proprio quella?». È qui che l’informatica contemporanea entra in un territorio al quale l’ingegneria tradizionale ci aveva preparati piuttosto male, perché il sistema è interamente materiale, interamente matematico ed interamente eseguibile su hardware progettato da esseri umani, eppure la spiegazione del comportamento di alto livello non discende automaticamente dalla disponibilità del suo tracciato numerico.
L’equivoco contenuto nella frase «non sappiamo come funziona l’AI»
Dire che nemmeno chi costruisce l’Intelligenza Artificiale sappia come funziona è suggestivo, ma preso alla lettera è falso, perché gli ingegneri sanno benissimo come funziona un Transformer, conoscono embedding, matrici dei pesi, attenzione, trasformazioni lineari, funzioni non lineari, residual stream, normalizzazioni, proiezione sul vocabolario, distribuzioni sui token e metodi utilizzati per addestrare il modello, inoltre quando dispongono dell’accesso necessario possono osservare le attivazioni interne mentre il modello elabora un input. Se chiediamo ad un LLM «come è possibile che l’uomo abbia costruito qualcosa capace di ragionare senza comprendere fino in fondo come quel ragionamento venga prodotto?», il testo viene suddiviso in token, i token vengono trasformati in rappresentazioni numeriche multidimensionali, queste rappresentazioni attraversano numerosi layer della rete nei quali i meccanismi di attenzione mettono in relazione parti differenti del contesto, le componenti MLP trasformano le rappresentazioni, il residual stream accumula informazione ed alla fine il modello produce una distribuzione numerica sui token possibili, seleziona il successivo e ripete il processo. Questa parte non è misteriosa e possiamo registrare che ad un certo livello esisteva un determinato vettore composto da migliaia di valori, che una certa attention head attribuiva maggior peso ad alcune posizioni del testo, che una particolare attività modificava il residual stream in una certa direzione e che il logit associato ad una parola risultava superiore a quello di un’altra, possiamo perfino intervenire causalmente su alcune rappresentazioni e verificare che la risposta cambia. Ma se a quel punto domandiamo all’ingegnere «perché da quella mia domanda il modello ha ricavato proprio questa particolare considerazione filosofica che non avevo espresso, e perché ha deciso di collegarla proprio a quest’altra idea?», il gigantesco tracciato numerico che possediamo smette improvvisamente di essere una spiegazione, perché descrivere ogni trasformazione elementare non equivale ancora a possedere una teoria comprensibile del modo in cui quella trasformazione collettiva ha prodotto un concetto.
Possediamo la registrazione dell’evento, ma non possediamo ancora la sua spiegazione
L’errore più naturale sarebbe immaginare che dentro un LLM esista qualcosa di simile al normale flusso di un programma, con un punto nel quale il sistema riconosce la domanda, un punto nel quale recupera il concetto A, un passaggio nel quale applica la regola B ed un ultimo blocco nel quale deduce C e decide quindi di rispondere D, perché in quel caso basterebbe un debugger sufficientemente sofisticato, qualche breakpoint ben piazzato ed il mistero sarebbe risolto. Un grande modello neurale però non funziona in questo modo, nessun programmatore ha scritto una funzione del tipo se_domanda_filosofica_allora_cerca_paradosso_epistemologico(), nessuno ha stabilito esplicitamente quale neurone debba rappresentare il concetto di paradosso, quale gruppo debba rappresentare l’ironia, quale debba stabilire che un’analogia è elegante oppure quale debba decidere che una determinata osservazione potrebbe sorprendere l’interlocutore, perché quelle strutture emergono durante l’addestramento dalla modifica di una quantità enorme di parametri. Dario Amodei, CEO di Anthropic, lo ha spiegato in maniera particolarmente efficace nell’aprile 2025 riprendendo una formula cara al cofondatore Chris Olah, secondo la quale i sistemi generativi vengono in un certo senso coltivati più che costruiti, perché l’uomo definisce l’architettura di base, il tipo di dati, l’algoritmo di addestramento, gli obiettivi e molte condizioni al contorno, mentre i meccanismi cognitivi dettagliati emergono all’interno della rete senza essere progettati uno per uno. Guardandovi dentro troviamo dunque enormi matrici di numeri che evidentemente stanno svolgendo operazioni cognitive importanti, ma la relazione fra quei numeri ed una spiegazione semantica compatta non è affatto immediata. La distinzione fondamentale è quindi fra TRACCIABILITÀ NUMERICA ed INTERPRETABILITÀ SEMANTICA, perché posso conoscere un numero senza sapere che cosa rappresenti, posso conoscere dieci milioni di numeri senza sapere quale concetto rappresenti la loro relazione e posso perfino conoscere esattamente il valore assunto da ogni variabile in una determinata computazione senza possedere una teoria sufficientemente compatta da spiegarmi perché quella configurazione abbia prodotto proprio quella idea.
Il seed non ci salverebbe
Quando ho iniziato a riflettere su questo problema mi sembrava naturale immaginare una risposta molto più banale da parte dell’ingegnere, qualcosa del tipo «guarda qui, il modello aveva questi token, questo era lo stato interno, il generatore pseudocasuale ha selezionato questa diramazione, da qui siamo passati a quest’altro livello e per questo è comparso il primo token della risposta, poi il processo si è ripetuto», ed una descrizione del genere può anche essere costruita almeno in parte, ma non risponde alla domanda. La casualità eventualmente introdotta nel sampling decide quale token estrarre da una distribuzione che il modello ha già prodotto, non spiega perché quella distribuzione abbia proprio quella forma, e la difficoltà rimarrebbe anche eliminando completamente il campionamento casuale e scegliendo ogni volta il token con probabilità maggiore. Un modello perfettamente deterministico potrebbe essere altrettanto opaco, perché sapere che il token X ha ottenuto probabilità 0,31 mentre Y ha ottenuto 0,27 descrive il risultato della computazione ma non ci dice ancora quali strutture concettuali distribuite nella rete abbiano prodotto proprio quella differenza. Il problema quindi non è che abbiamo perso il filo dell’esecuzione, il filo esiste, il problema è che quel filo è composto da matematica ad altissima dimensionalità e non da una sequenza di proposizioni scritte nella nostra lingua, ed è precisamente la differenza fra possedere una registrazione e possedere una spiegazione.
Come abbiamo potuto costruire qualcosa che non sappiamo spiegare fino in fondo
A prima vista sembrerebbe quasi una contraddizione logica, perché se l’abbiamo costruita noi dovremmo sapere che cosa abbiamo costruito, ma non è così perché il machine learning ha cambiato il significato stesso del verbo costruire. Nella programmazione classica il programmatore costruisce direttamente la procedura, definisce condizioni, variabili, trasformazioni e percorsi attraverso i quali input differenti produrranno output differenti, mentre in un sistema appreso il programmatore costruisce soprattutto IL PROCESSO ATTRAVERSO IL QUALE EMERGERÀ LA PROCEDURA, cioè prepara la macchina capace di modificare i propri parametri durante l’addestramento, definisce la funzione secondo cui alcune configurazioni interne saranno migliori di altre ed esegue quell’ottimizzazione un numero enorme di volte. Alla fine non ottiene qualche milione di righe aggiuntive di codice leggibile, ottiene miliardi di parametri numerici la cui configurazione collettiva contiene strutture capaci di tradurre, programmare, classificare, generalizzare, costruire analogie, riconoscere relazioni e risolvere problemi. È per questo che Amodei ha definito questa situazione essenzialmente senza precedenti nella storia della tecnologia, non perché avremmo creato qualcosa di soprannaturale ma perché abbiamo prodotto un artefatto attraverso ottimizzazione invece che attraverso una specificazione completa dei suoi meccanismi cognitivi. Il progettista conosce dunque molto bene le leggi attraverso le quali il sistema viene addestrato e sviluppato, ma non necessariamente la struttura funzionale dettagliata che quel processo ha fatto emergere.
Il fenomeno della superposition: un concetto non abita necessariamente in un neurone
Una delle ragioni tecniche più importanti di questa difficoltà è la superposition, perché l’immagine intuitiva secondo cui dovrebbe esistere un neurone per «Parigi», uno per «ironia», uno per «menzogna» ed uno per «filosofia» è nella maggior parte dei casi troppo semplice. Alcune unità possono mostrare associazioni relativamente interpretabili, ma nei grandi modelli linguistici molte caratteristiche vengono rappresentate in maniera distribuita e sovrapposta nello stesso spazio neurale, con un singolo neurone che può partecipare alla rappresentazione di più concetti ed un singolo concetto che può dipendere contemporaneamente da molte unità. Questo permette al modello di rappresentare più caratteristiche di quante dimensioni immediatamente leggibili possieda, sfruttando una geometria distribuita che è efficiente dal punto di vista della capacità ma pessima dal punto di vista di chi vorrebbe associare ad ogni elemento interno un’etichetta umana. Anthropic ha lavorato proprio su questo problema utilizzando sparse autoencoders, cioè strumenti che cercano di scomporre le attivazioni sovrapposte in features più sparse ed interpretabili, arrivando già nel 2024 e 2025 ad identificare decine di milioni di features in modelli commerciali, e lo stesso Amodei ricordava che Claude 3 Sonnet aveva prodotto oltre 30 milioni di caratteristiche individuabili con questi metodi, mentre ipotizzava che anche modelli relativamente piccoli potessero contenere un miliardo o più di concetti. Questo dettaglio spiega una cosa che considero fondamentale, perché non abbiamo necessariamente davanti un codice segreto che aspetta soltanto di essere decifrato parola per parola, potremmo trovarci di fronte ad una rappresentazione che non è mai stata organizzata per essere comprensibile a noi, dato che l’ottimizzazione non aveva nessun motivo per produrre una mente ordinata secondo i nostri manuali, doveva soltanto produrre buoni risultati.
L’interpretabilità non è fallita, ma la distanza dalla spiegazione completa resta enorme
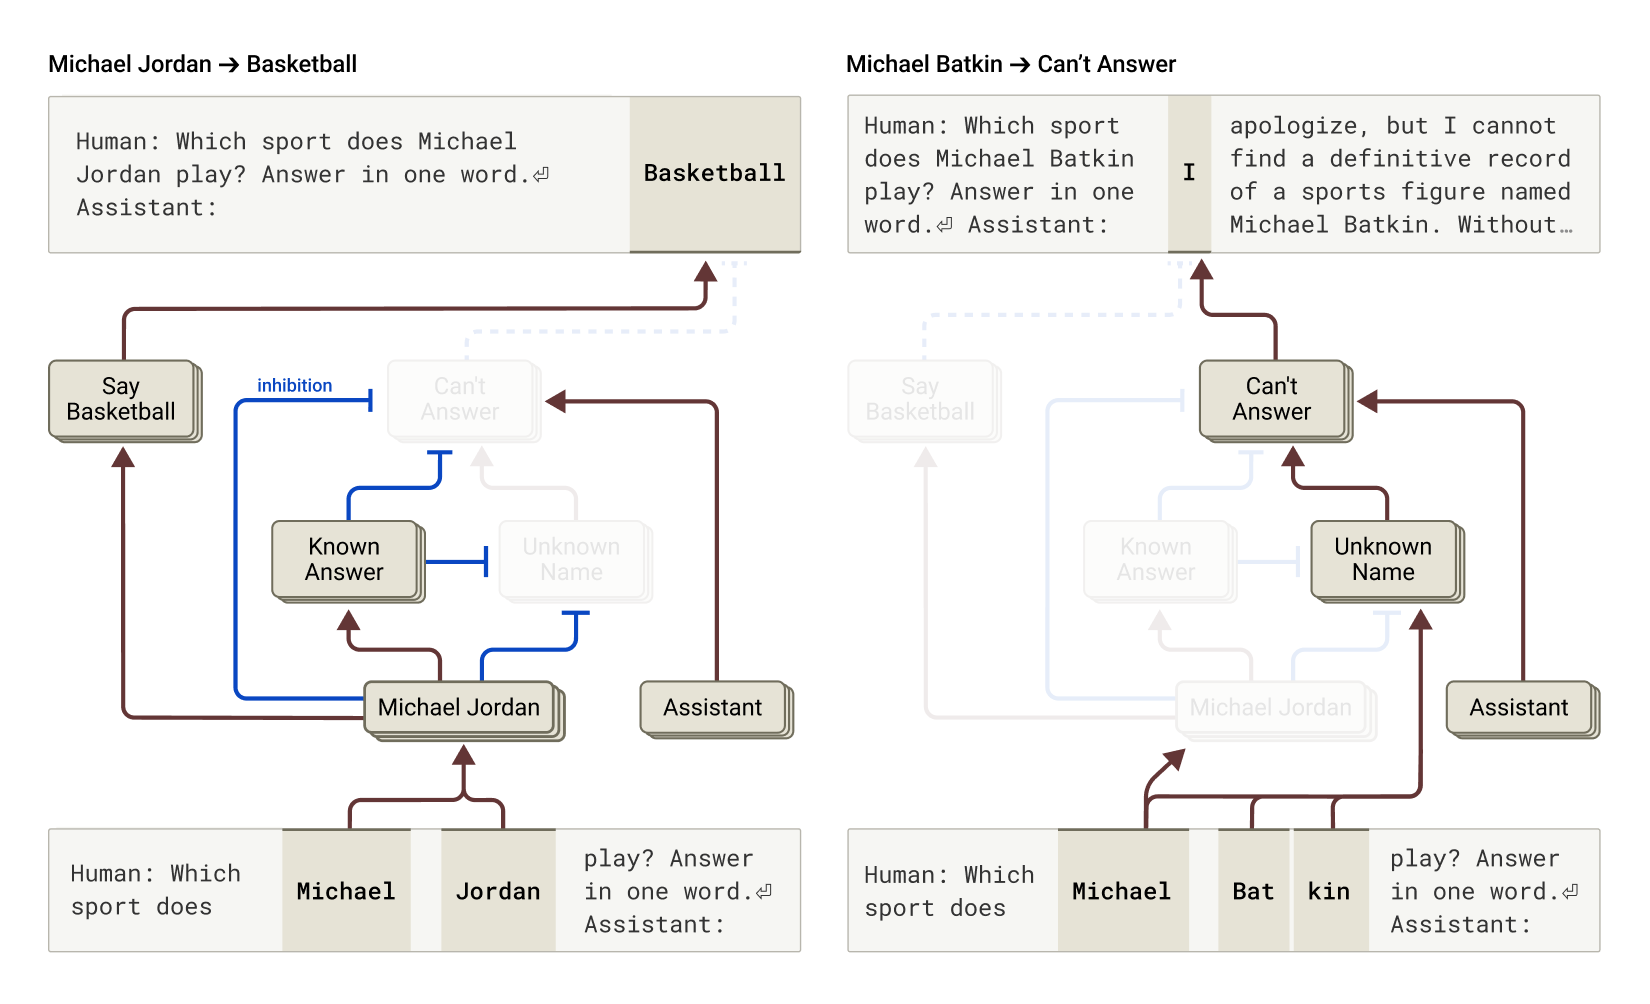
Dire che nel 2026 l’interpretabilità non funziona sarebbe tecnicamente sbagliato, perché negli ultimi due anni sono comparsi risultati che fino a poco tempo fa avremmo considerato straordinari, ed Anthropic nel marzo 2025 ha pubblicato esperimenti di circuit tracing nei quali riusciva a ricostruire porzioni delle catene causali interne utilizzate da Claude. In uno degli esempi più famosi, mentre il modello doveva completare una poesia, i ricercatori trovarono evidenza del fatto che Claude rappresentasse con anticipo una possibile parola finale in rima e costruisse la riga in modo da arrivarvi, e modificando quella rappresentazione interna riuscivano a cambiare il risultato finale; in un altro esperimento, alla domanda «qual è la capitale dello Stato nel quale si trova Dallas?», il sistema mostrava prima una rappresentazione corrispondente al fatto che Dallas si trova in Texas e poi collegava quel passaggio al fatto che la capitale del Texas è Austin, mentre sostituendo artificialmente il concetto intermedio Texas con California la risposta cambiava da Austin a Sacramento. Questi risultati dimostrano non soltanto correlazioni ma anche relazioni causali, perché intervenire sulla rappresentazione cambia sistematicamente l’output, però gli stessi ricercatori sottolineavano che perfino su prompt brevi e semplici il metodo catturava soltanto una frazione della computazione complessiva e che erano necessarie ore di lavoro umano per comprendere circuiti relativi a poche decine di parole. Abbiamo quindi microscopi migliori, vediamo strutture che prima non vedevamo ed iniziamo a manipolarle, ma fra il vedere alcuni circuiti ed il poter spiegare integralmente una risposta complessa rimane ancora una distanza enorme.
Natural Language Autoencoders: quando costruiamo una macchina per tradurre la macchina
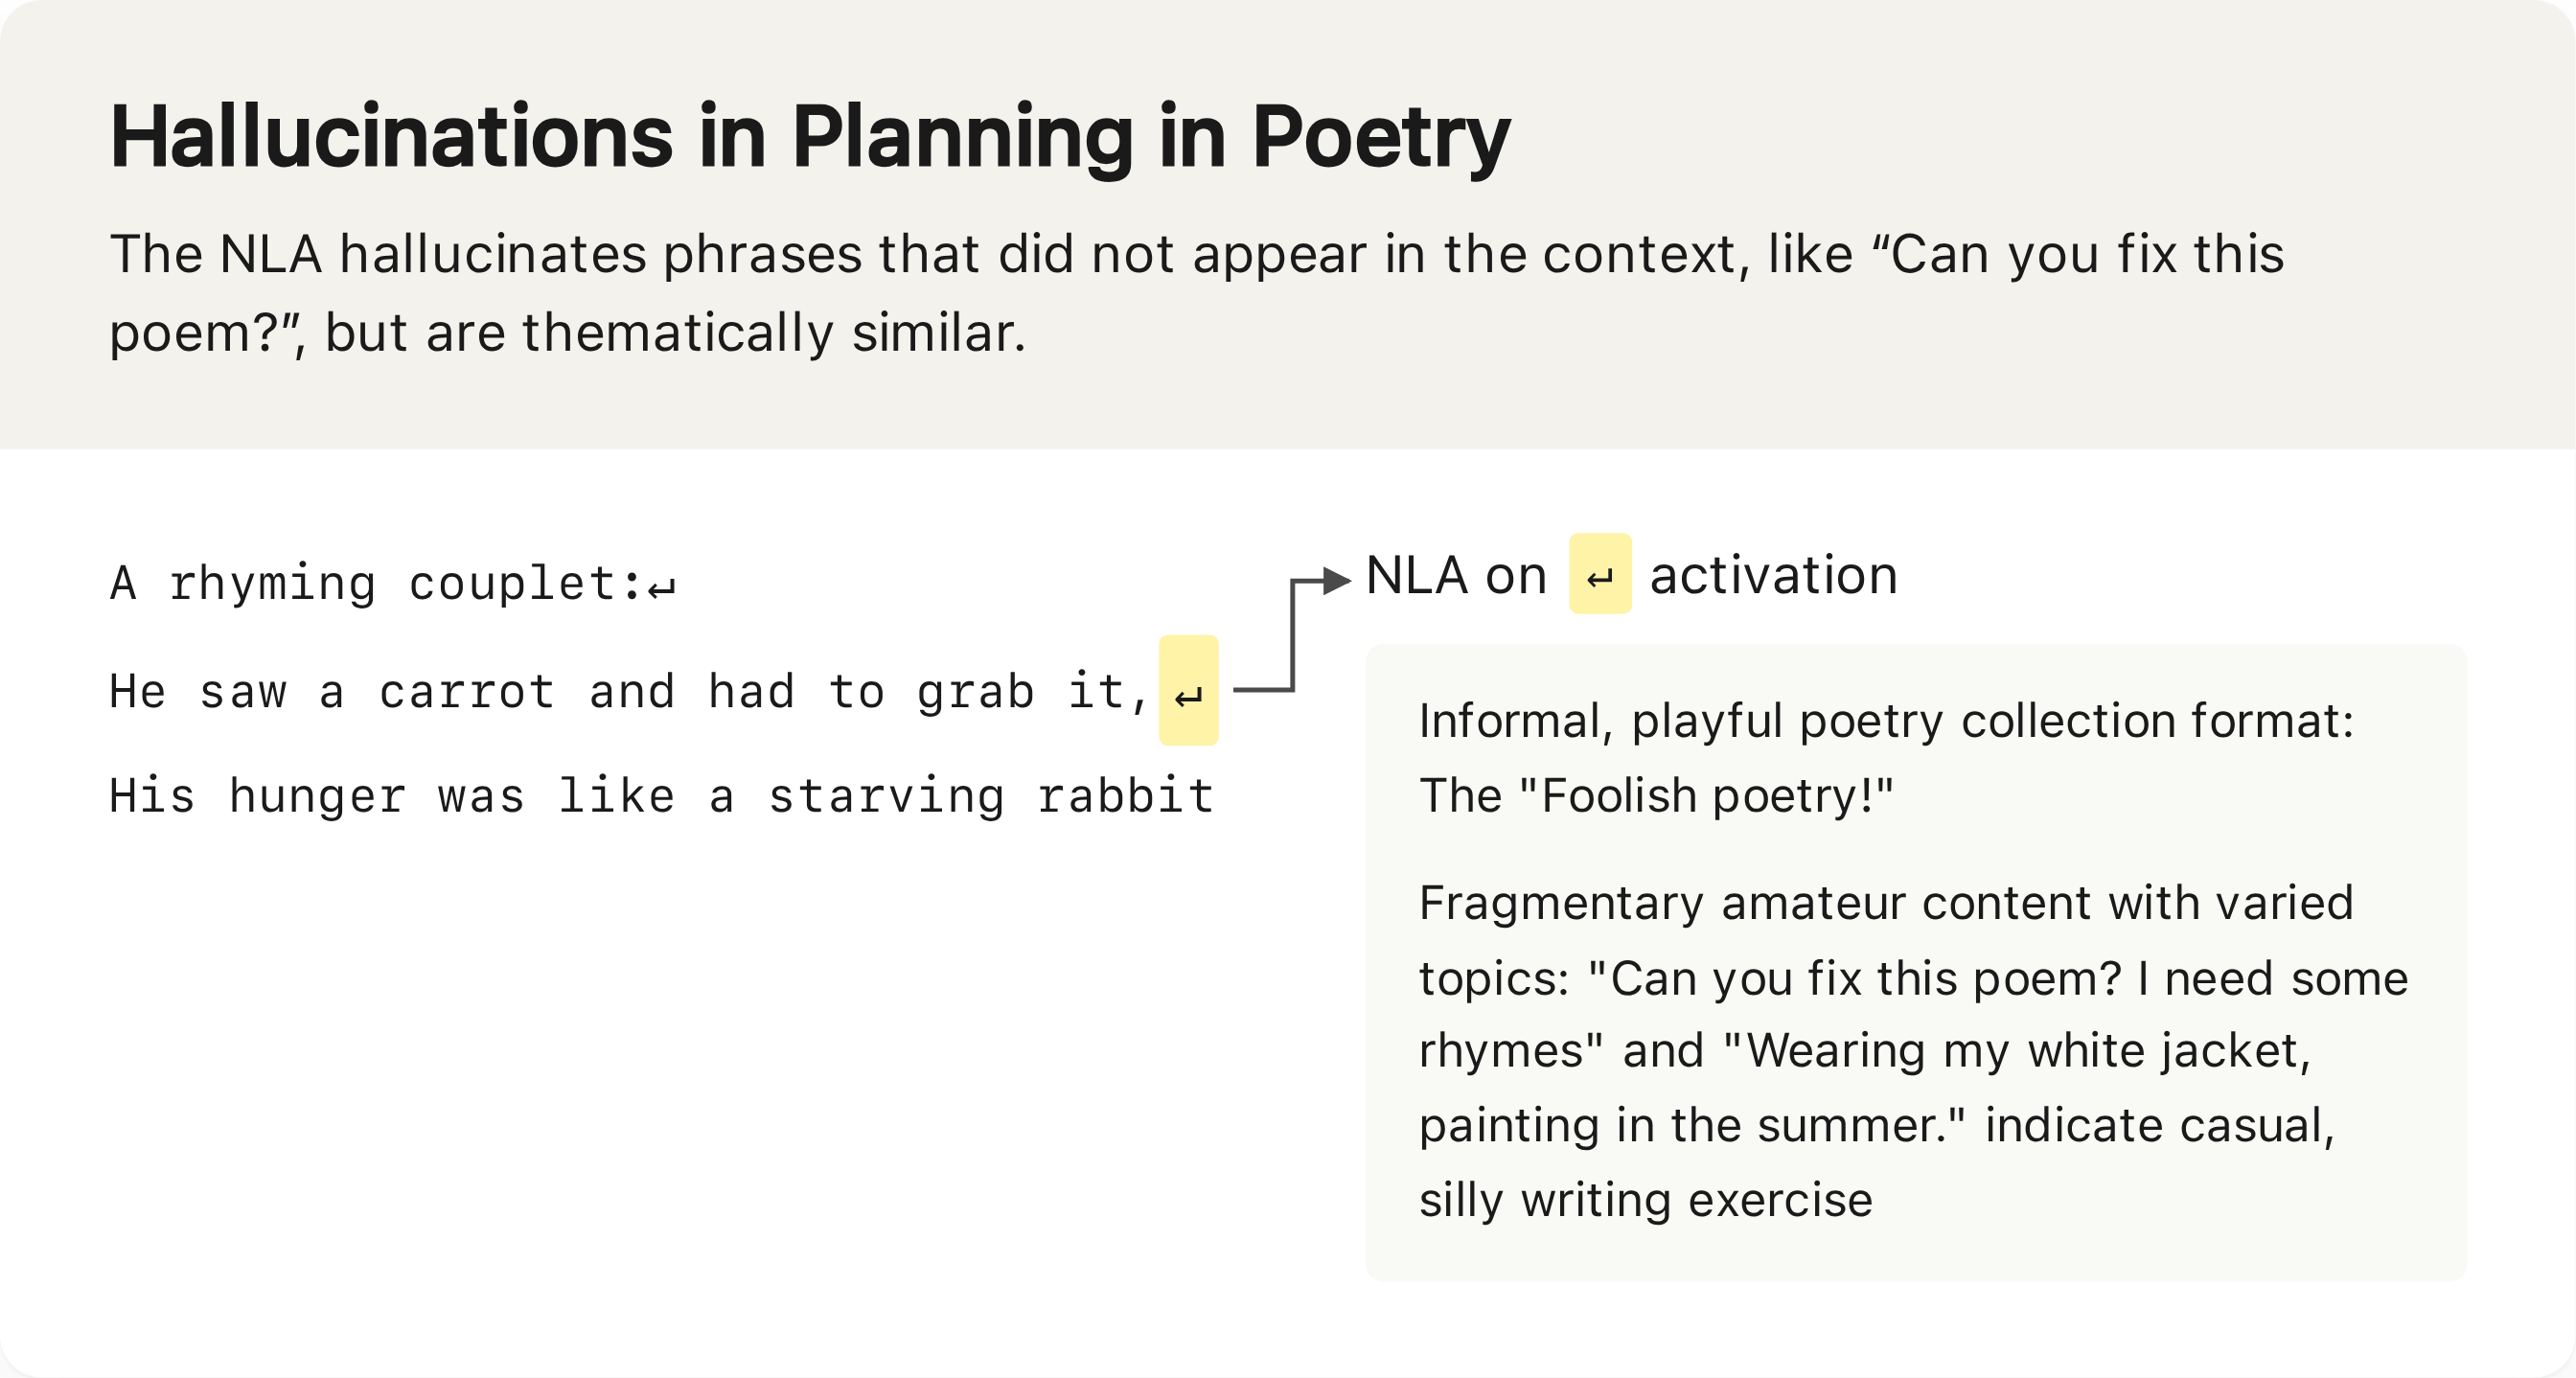
Nel maggio 2026 Anthropic ha compiuto un altro passo con i Natural Language Autoencoders, sistemi progettati per trasformare determinate attivazioni interne di Claude in descrizioni linguistiche leggibili, ed il principio è affascinante perché una componente produce una descrizione in linguaggio naturale dello stato interno mentre un’altra tenta di ricostruire da quella descrizione l’attivazione originaria, così che la qualità della ricostruzione dia una misura di quanta informazione sia stata catturata dal testo. In altre parole abbiamo costruito una macchina che osserva un’altra macchina e prova a tradurre una parte del suo stato interno in concetti comprensibili agli esseri umani, ma proprio Anthropic avverte che queste spiegazioni possono essere sbagliate e possono inventare dettagli che non erano presenti nel contesto originale, quindi gli stessi ricercatori le usano come uno strumento esplorativo da sottoporre poi ad altre verifiche indipendenti. È una situazione quasi paradossale, perché abbiamo costruito una macchina che interpreta la macchina che abbiamo costruito, ma non possiamo ancora fidarci completamente dell’interpretazione prodotta dalla macchina che interpreta la macchina, ed a mio parere è difficile immaginare una fotografia più efficace del punto nel quale si trova oggi la ricerca.
Nemmeno chiedere direttamente all’AI «perché hai risposto così?» risolve la questione
La soluzione più ovvia sembrerebbe chiederglielo direttamente, ed effettivamente i modelli moderni sono straordinariamente bravi a produrre spiegazioni delle proprie risposte, ma confondere la qualità retorica di una spiegazione con la prova che quella spiegazione corrisponda al processo causale realmente avvenuto sarebbe un errore. Il problema viene studiato attraverso il concetto di faithfulness della chain of thought, perché numerosi lavori hanno mostrato che un modello può produrre una razionalizzazione plausibile senza verbalizzare tutti i fattori che hanno realmente influenzato la risposta, oppure può omettere segnali importanti, ricostruire a posteriori una motivazione coerente od utilizzare indizi che non dichiara esplicitamente. OpenAI ha dedicato nel 2025 un intero filone di ricerca alla monitorabilità delle chain of thought, mostrando che queste tracce sono estremamente utili per capire proprietà del comportamento dei modelli e spesso risultano molto più informative del solo output finale, ma contemporaneamente ha trattato la monitorabilità come una proprietà da misurare e non come una garanzia assoluta di fedeltà. La risposta dell’AI alla domanda «perché hai detto questo?» è quindi un altro dato da analizzare, non l’accesso privilegiato alla verità ultima sul proprio funzionamento, ed anche questo possiede una curiosa analogia con noi esseri umani, che siamo perfettamente capaci di fornire una motivazione convincente delle nostre decisioni senza che quella motivazione coincida necessariamente con tutte le cause che le hanno realmente prodotte.
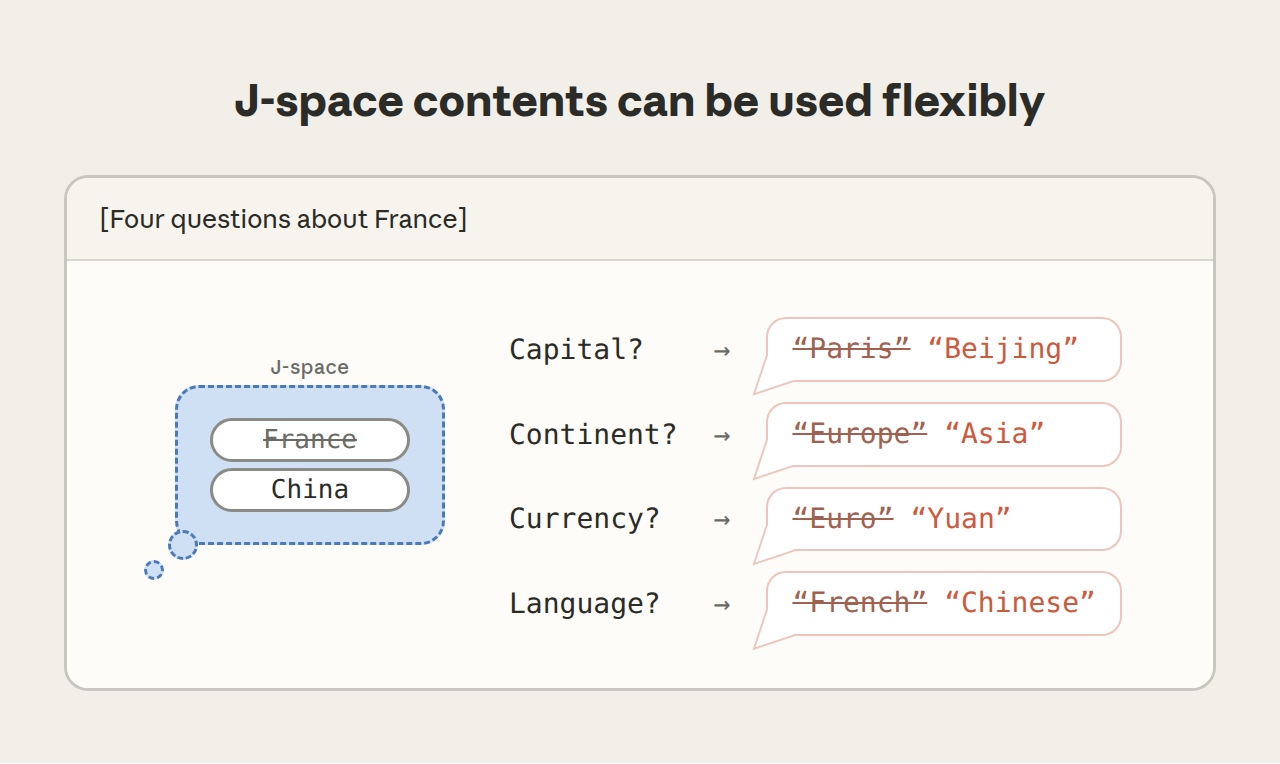
È forse questa la trasformazione epistemologica più singolare prodotta dall’Intelligenza Artificiale moderna, perché per la prima volta su questa scala l’ingegnere, dopo aver costruito un sistema, deve studiarlo sperimentalmente quasi come se fosse un fenomeno naturale, non si limita ad aprire il sorgente ma lo stimola, misura le reazioni, disattiva una rappresentazione ed osserva che cosa cambia, amplifica una feature, confronta migliaia di esecuzioni, costruisce strumenti che ricordano metaforicamente microscopi, elettrodi oppure risonanze magnetiche. Nel luglio 2026 Anthropic ha pubblicato risultati relativi a quello che chiama J-space, cioè un piccolo insieme di rappresentazioni interne di Claude individuato attraverso una tecnica basata sul Jacobian e caratterizzato da proprietà che ricordano sul piano funzionale il global workspace studiato nelle neuroscienze cognitive, con informazioni interne che possono diventare disponibili ad altri processi, essere riportate dal modello, modificate su richiesta ed utilizzate per ragionamento multi-step. Il J-space non era stato programmato esplicitamente dagli ingegneri ma è emerso durante l’addestramento, e quando i ricercatori sostituiscono nel J-space un concetto con un altro possono deviare causalmente risposte successive, come accade sostituendo «spider» con «ant» nel passaggio interno di un problema sul numero di zampe oppure sostituendo «France» con «China» e osservando che cambiano coerentemente capitale, lingua, continente e valuta. Anthropic sottolinea però con estrema chiarezza che questi risultati NON dimostrano che Claude sia cosciente oppure che provi qualcosa, mostrano invece una struttura funzionale interna che ricorda alcuni aspetti del conscious access e che non era stata progettata elemento per elemento. È proprio questo, molto più di qualsiasi slogan sulla AI senziente, a meritare attenzione filosofica, perché abbiamo certamente creato un oggetto artificiale la cui organizzazione interna è diventata sufficientemente complessa da richiedere una scienza empirica dedicata per essere compresa, ed il progettista si è trasformato in una specie di biologo della propria macchina.
Ma allora l’AI pensa davvero
Qui bisogna resistere sia all’entusiasmo sia alla paura delle parole, perché se con «pensare» intendiamo possedere esperienza soggettiva, coscienza fenomenica, sensazioni, desideri oppure un proprio punto di vista sull’esistenza, le conoscenze attuali non consentono di affermarlo, ed Anthropic stessa specifica che i risultati sul J-space non dimostrano che Claude provi esperienze o sentimenti. Se però utilizziamo «pensare» in senso funzionale, cioè effettuare trasformazioni interne dell’informazione che permettono di combinare concetti, pianificare, inferire relazioni, mantenere passaggi intermedi ed utilizzare rappresentazioni interne per guidare una conclusione, la questione diventa molto meno semantica, perché gli esperimenti di interpretabilità mostrano ormai precisamente questo tipo di comportamento. Un LLM continua naturalmente, al livello finale dell’interfaccia matematica, a produrre una distribuzione sul token successivo, ma dire soltanto che «sceglie statisticamente la parola successiva» è un po’ come descrivere una CPU dicendo che modifica stati elettrici, perché l’affermazione è vera e contemporaneamente perde quasi tutta l’informazione interessante relativa ai livelli superiori di organizzazione. Il problema filosofico dell’interpretabilità nasce esattamente nello spazio fra questi due livelli, perché conosciamo bene il livello inferiore, osserviamo con crescente precisione quello superiore e stiamo ancora costruendo la teoria capace di collegarli completamente.
La macchina è più accessibile del cervello umano, eppure non riusciamo ancora a leggerla per intero
Esiste una caratteristica che rende il caso dell’AI perfino più strano dell’analogia neuroscientifica, perché nel cervello umano non possiamo registrare individualmente ogni neurone, ogni sinapsi ed ogni scambio elettrochimico, salvare l’intero stato e ripetere perfettamente lo stesso cervello nelle stesse condizioni, mentre in una rete neurale artificiale, almeno in linea di principio e disponendo dell’accesso al modello, possiamo copiare i pesi, osservare le attivazioni, eseguire interventi artificiali, ripetere esperimenti ed isolare causalmente alcune componenti. Eppure non riusciamo ancora a trasformare quella disponibilità quasi totale del livello fisico-matematico in una comprensione altrettanto totale del livello concettuale, ed è qui che emerge quello che considero un problema di COMPRESSIONE DELLA SPIEGAZIONE, perché una sequenza di miliardi di valori può essere una descrizione perfettamente esatta e contemporaneamente una spiegazione completamente inutile per un essere umano. Per capire abbiamo bisogno di trovare invarianti, strutture, concetti, causalità e gerarchie, dobbiamo ridurre miliardi di operazioni ad una rappresentazione che conservi ciò che conta senza perdere proprio ciò che intendiamo spiegare, ed è possibile che qui si nasconda una delle lezioni filosoficamente più profonde dell’intera vicenda, cioè che conoscere integralmente lo stato microscopico di un sistema non equivale necessariamente a comprenderlo.
Forse la vera anomalia non è l’AI, ma la nostra idea di ciò che significa «aver costruito qualcosa»
Per secoli abbiamo associato l’artefatto alla trasparenza dell’intenzione del costruttore, perché un martello ha la forma che qualcuno gli ha dato, un orologio contiene ingranaggi disposti secondo un progetto ed un programma tradizionale esegue istruzioni che, per quanto numerose e complicate, derivano da una struttura esplicita scritta dall’uomo. Il machine learning ha interrotto questa continuità perché abbiamo iniziato a costruire sistemi facendo sì che fosse l’ottimizzazione a scoprire la struttura adatta a risolvere il problema, separando così la capacità di PRODURRE un meccanismo dalla capacità di COMPRENDERE completamente il meccanismo prodotto. Questo passaggio non è nato nel 2026 e nemmeno con ChatGPT, è inscritto nella storia stessa delle reti neurali e dell’apprendimento automatico, ma ciò che è cambiato è la scala, perché finché il sistema distingueva fotografie di cani e gatti la sua opacità poteva sembrare una curiosità accademica, mentre quando lo stesso paradigma genera sistemi capaci di scrivere software, discutere di filosofia, analizzare una sentenza, progettare un esperimento oppure individuare strategie alle quali il progettista non aveva pensato, quella curiosità diventa una questione epistemologica, sociale e inevitabilmente politica. Una cosa è usare una scatola nera per stabilire se una fotografia contiene un gatto, un’altra è delegare a quella scatola parti crescenti della produzione intellettuale umana.
Il vero confine del 2026
Per questo non penso che la conclusione corretta sia che l’interpretabilità sia fallita, perché sarebbe una lettura troppo semplice ed alla luce dei risultati recenti anche tecnicamente sbagliata, l’interpretabilità sta funzionando ma funziona ancora A FRAMMENTI, riusciamo a riconoscere alcune features, ricostruire alcuni circuiti, individuare rappresentazioni intermedie, intervenire causalmente su di esse, osservare strutture come il J-space ed iniziare perfino a tradurre determinate attivazioni in linguaggio naturale. Ma da tutto questo alla possibilità di prendere una qualunque risposta complessa di un modello di frontiera e dire con affidabilità «ha compreso la tua domanda in questo modo, ha richiamato questi concetti, ha escluso quest’altra interpretazione per questa ragione, ha costruito questa analogia attraverso questi passaggi, ha valutato queste alternative ed infine ha scelto questa formulazione perché queste rappresentazioni e non altre hanno causalmente determinato il risultato», la distanza rimane enorme. Ed è forse proprio questa distanza a rappresentare uno dei fatti tecnologicamente più straordinari del nostro tempo, perché l’uomo conosce la formula dell’attenzione, conosce l’algebra lineare, conosce i pesi, conosce gli algoritmi di addestramento, conosce il codice che esegue il modello e può osservare numericamente una parte vastissima di ciò che accade al suo interno, eppure può ancora formulare una domanda filosofica ad una macchina che ha costruito, leggere una risposta sorprendentemente pertinente e domandare all’ingegnere che l’ha progettata «perché ha pensato proprio questo?», ottenendo dopo tutta la matematica, tutti i grafici e tutte le attivazioni disponibili una risposta scientificamente molto più sofisticata ma concettualmente non troppo distante da «ne comprendiamo alcune parti, ma l’intero processo ancora no». Non credo serva attribuire un’anima alla macchina per trovare tutto questo impressionante, semmai è il contrario, perché il vero mistero dell’AI contemporanea non consiste nell’aver dimostrato che una macchina possiede una mente simile alla nostra, consiste nell’aver dimostrato che l’uomo può costruire un sistema artificiale completamente materiale, completamente matematico, completamente contenuto in hardware progettato da esseri umani e nonostante questo sufficientemente complesso da diventare per i propri creatori un nuovo oggetto di scoperta scientifica. Non abbiamo costruito qualcosa che viola le leggi che conosciamo, abbiamo costruito qualcosa le cui leggi elementari conosciamo benissimo ed il cui comportamento organizzato continuiamo, in parte, a scoprire dopo averlo costruito, forse è questa la differenza più importante ed anche quella più difficile da accettare!

Commenti
Nessun commento, per ora.
Per commentare serve un accesso. Qui siamo tutti tecnici e colleghi!
Accedi per commentare